1. Subagent 是什么,有什么用
Subagent 是一个专门的助手,Claude Code 会把任务交给它:它在自己独立的上下文窗口里完成工作,再向您的会话返回一份简短的总结。文件的读取、搜索和工具调用都留在它自己的上下文里。
为什么要这样做:在主会话里工作时,消息、读过的文件和命令的输出都占用同一个窗口的空间,而这个窗口不是无限大的。窗口越来越满时,Claude Code 会精简历史记录,一部分细节可能因此丢失。Subagent 能把中间过程挪到一个独立的窗口里,主对话里只留下它的结果。
最简单的 subagent
第一次使用,只需要在 Claude Code 里发一条普通消息:明确要求调用 subagent,并描述它的任务。不需要提前写好角色文件,这种任务用内置的助手就够了。比如:
调用一个 subagent 读取文件 index.html。
让它整理出这个文件的简短结构图:主要有哪些部分,
每个部分是干什么的。然后用 3-5 句话
写一份内容摘要。
不要修改文件。把 subagent 的回答返回到这个会话里。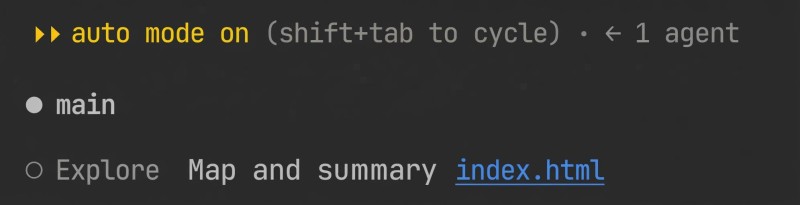
主智能体会把任务交给助手,完成后在您的对话里显示它的回答。在后台运行时,输入框下方会出现一个状态条,显示 subagent 的名字和工作状态。点一下就能打开 subagent 的会话,看它在读什么、做什么。工作过程中留意一下,是不是真的启动了一个独立的 subagent 运行:普通文字请求会引导 Claude 的选择,但它本身并不保证任务一定会被委派出去。
Subagent 能拿到什么
如果同一项任务要按固定规则反复执行,可以在文件里定义一个自己的角色。这样一个自定义 subagent 一开始有两个主要输入:
- 角色指令,来自您的配置文件 - 专长和行为规则;
- 任务描述,由主智能体根据您的请求写出来。
除此之外,Claude Code 还会自动为它补上一些公共背景信息:项目的 CLAUDE.md 文件、一份 git status 快照,以及运行环境的相关信息。您和主智能体之间的对话不在其中。
这张图上最重要的一点是:subagent 在自己的窗口里完成任务,向主对话返回的是一份总结。主智能体不需要加载所有中间的读取和搜索过程。不过这份总结本身,仍然要占用主上下文里的空间。
这种分离也有代价:总结看不出得出结论的完整过程。您可能注意不到助手缺了哪些数据,或者它有哪些地方没有核实过。所以回答里需要有依据和限制说明,而它的结论也值得核实一下。
为什么 Claude 不会记住一切
上下文窗口是模型准备下一条回答时手头掌握的信息:指令、能看到的对话历史、读过的代码、命令的输出结果。正因为这样,智能体才能沿用您几条消息之前讨论过的决定。这个窗口有上限,不会把整段对话所有细节永远都存着。
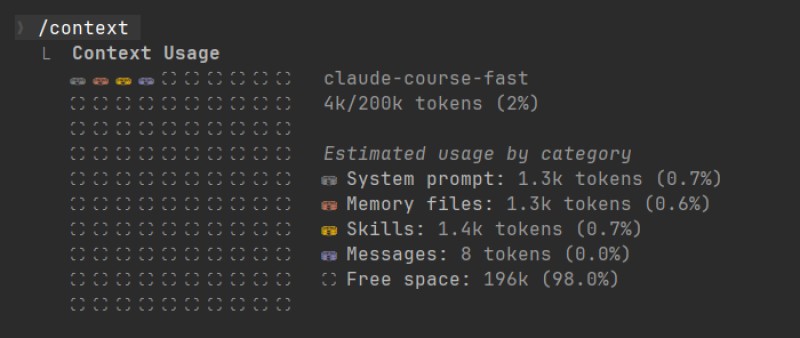
截图里 /context 命令显示的是 4k/200k tokens (2%):可用的 20 万个 token 里,已经用掉大约 4 千个。Token 是文本的一个小片段:一个词、词的一部分,或者一个符号。所以 20 万个 token 不等于 20 万个单词。这是截图中这个会话的窗口大小,换一个模型或配置可能会不一样。

下面能看到具体是什么在占用空间:System prompt - 系统指令,Memory files - 加载的记忆和规则文件,Skills - skill 相关信息,Messages - 消息。这里几乎没有对话内容,但窗口的一部分已经被指令占用了。Free space: 196k (98.0%) 这一行显示的是剩余的空闲空间。随着对话推进、文件读取和命令执行,它会逐渐被消耗掉。
保存下来的对话记录和当前的上下文窗口是两回事。对话可以留在会话历史里,但模型准备回答时拿到的只是有限的一部分信息。窗口接近上限时,Claude Code 会精简历史记录,其中包括把细节替换成简短概述。这不是瞬间忘掉整段对话:一部分信息会保留在总结里。但对话开头的某个具体条件、某个解释,或者被否掉的方案,可能进不了这份总结。到那时,智能体就没法再依靠这个细节了,除非您重新提一下,或者它重新读一遍原始来源。
文件的情况类似:项目里存在 app.js 这个事实,不代表它的内容已经进了窗口。智能体得先去读它。CLAUDE.md 里的通用指令可以重新加载,但它不会把聊天里的所有决定都恢复回来。
举个例子,您和智能体约定过,名称相同的商品要算作不同的记录。如果这个条件只留在对话里较早的部分,压缩之后可能就拿不到了。在做重要检查之前,重复一遍这个条件,或者让它去读记录着这条规则的文档,是个好习惯。
接下来,我们通过一个用于读代码的自定义 reviewer 来拆解这套机制:它能拿到哪些信息,怎样创建它的角色文件。这里说的是一次全新的普通启动;继续之前的工作或者传递一份历史副本,这个例子里用不上。
2. Reviewer 对项目了解多少
独立的上下文不代表助手一无所知。它有初始指令,也能访问项目。我们例子里这个自定义 reviewer 的信息来源是这些:
| 信息 | 怎么传到 reviewer 那里 |
|---|---|
| 固定的检查规则 | 来自角色文件:该做什么,能用哪些工具,要返回什么 |
| 具体任务 | 主智能体根据您的请求写出这次的任务 |
| 项目的代码和文档 | Reviewer 自己打开检查需要的、它能访问的文件 |
| 项目的通用规则 | 如果有适用的 CLAUDE.md 文件,会自动加载 |
CLAUDE.md 是一个存放 Claude Code 通用指令的文件:比如源代码放在哪里,项目里定下了哪些约定。不需要专门为这次检查再新建一个。
您的对话历史不会自动传过去。就算主智能体已经读过 app.js,这次读取的内容本身也不会自动出现在 reviewer 那里。但文件并没有消失:助手可以重新打开它。
聊天里的决定也是同样的情况。假设您讨论过,清单里两个同名的商品应该算作不同的记录。对删除功能的检查来说,这是一条重要要求。它要么由主智能体写进任务里,要么由助手读到记着这条要求的文档,reviewer 才能拿到。
我们这个 reviewer 没有工具能直接向您提问。所以数据不够的时候,它应该写清楚缺了什么,再把能给的那部分结果返回。主智能体可以再向您确认这个条件。"就按我们之前说的"这种说法,最好直接换成那个决定本身。
3. 创建角色文件
把角色文件放进项目里的 .claude/agents/reviewer.md。用户级文件夹 ~/.claude/agents/ 也可以存放跨项目共用的角色;~ 符号代表用户的主目录。现在项目级的方案就够用了。
创建这个文件,直接向 Claude Code 提要求就行:
创建 .claude/agents/reviewer.md,用来在不修改的前提下
检查页面代码。只允许 Read、Grep、Glob。
Reviewer 返回有依据的发现、已检查的范围
和限制说明;没有发现问题也可以。
把创建好的文件内容显示出来。
结果应该是一个普通的文本文件,没什么魔法。下面是一个现成的版本:可以拿它跟智能体给出的回答对比,或者直接自己保存下来用。如果您已经有同名的角色了,先看一下它的内容,别不小心把需要的指令替换掉。
---
name: reviewer
description: 检查已完成页面的代码是否有行为上的错误,返回有依据的报告。当有人要求只审查页面、不做修复时使用。
tools: Read, Grep, Glob
---
按给定的要求研究指定文件的代码。
不要修改文件。不要承诺运行页面:你只有读取和搜索的能力。
每条发现都要说明位置、预期行为、结论的依据、
验证条件和影响。如果数据不够,要说明这一点。
另外单独列出检查过什么、没检查什么。
如果按给定标准没发现问题,就照实写出来。
两行 --- 之间的部分叫 frontmatter:写在 Markdown 文件开头的配置。这里 name 设定角色的名字,description 告诉主智能体什么时候该选它,tools 列出它能用的工具。下面是普通的文字指令。
例子里的三个工具,正好够用来浏览代码:Read 读文件,Grep 按内容搜索,Glob 按名字或路径找文件。所以 reviewer 能找到删除功能的代码并读取它,但不会在浏览器里运行页面,也不会在终端执行命令。
"不要修改文件"这句话描述的是任务本身。tools 字段限制的是执行任务能用的手段。如果只在文字里提要求,却不限制工具,助手手上可能还留着写入的能力。在这份现成的例子里,两部分都已经到位,后面不用再补限制。
角色文件看着有点像 skill:配置加指令文字。确实容易搞混。但这里我们设置的是一次用来检查的独立运行。Skill 通常是把一套可重复的流程加进当前对话,尽管 skill 也可以在独立的上下文里运行。选哪一种,要看工作该怎么执行,而不是看两种文件长得像不像。
4. 核实并调用 reviewer
硬盘上有这个文件,只是第一步。现在看看会话能不能识别它。打开文件,看看名字 reviewer、描述、工具那一行和正文:里面有没有承诺要打开浏览器或者直接修复错误。
在 Claude Code 的输入框里输入 @,选带 agent 标记的 reviewer。要选的是这个角色,而不是外观相似、指向文件路径的那个选项。从列表里选,就能明确指定这次任务交给谁执行。
如果找不到这个角色,先检查路径:文件应该放在已打开项目的 .claude/agents/ 里。再检查 frontmatter:两行分隔符、名字和描述都要在。也可以直接让 Claude Code 帮您核对这个定义文件。
根据 Claude Code 的文档,对已被监视的文件夹所做的改动,几秒钟内就会生效。但如果 agents 文件夹是会话启动之后才第一次出现的,就需要重启。先结束当前会话,然后在普通终端里,从同一个项目文件夹执行:
claude --continue这条命令会从当前目录继续上一次的对话。启动之后再检查一遍 @ 列表。启动 Claude 这条命令是退出后在终端里敲的,不是在已经打开的对话里输入的。
第一个任务就用购物清单页面来试:结构在 index.html 里,逻辑在 app.js 里,两个文件都在项目根目录。换成您自己的项目时,把路径和预期行为改成您自己的。从列表里选好 reviewer 之后,在这条 @ 后面补上这样一段文字:
研究项目根目录下的 index.html 和 app.js。
检查添加和删除条目:计数器应该跟剩下的
条目数一致,删除一条记录不应该
连带删掉另一条同名的记录。
不要修改文件。返回代码层面的结论,以及需要在浏览器里
再验证的部分。
这里已经具备了一次范围明确的检查所需要的一切:去哪里找、该发生什么、需要什么样的结果。这里不需要单独写一份任务书文件。主智能体会为选中的 reviewer 拟出具体任务;通过 @ 做的选择,决定的是由谁执行,而不是把您的消息原样转述过去。
5. 结果是怎样返回的
发出请求之后,看看是不是启动了 reviewer 的运行。在普通的交互式会话里,这类工作可以在后台进行:您能在面板里看到它,同时还能继续对话。/tasks 命令能帮您查看任务,包括最近完成的那些。
检查结束后,主智能体会拿到结果并转告您。如果转述得太简略,可以要求:"把 reviewer 的完整报告贴出来"。这样更容易保留发现问题的准确说法和检查的限制条件。
比如,一份关于计数器的示范报告可能是这样的:
检查了 app.js 里的添加和删除功能。
在 removeItem() 里列表会重新渲染,但没找到
这条路径上有调用 updateCounter()。预期计数器应该
显示剩余记录的数量。
浏览器验证:添加一条,删除它,
对比计数器和空列表的情况。
没有单独检查删除同名记录的情况。
没有在浏览器里运行过。
这只是一个回答形式的示范,不是承诺会在您的页面上找到一模一样的 bug。我们这个 reviewer 只有读代码的能力,所以最后一句话如实说明了它的能力边界。即便没有运行程序,代码层面的结论也可以是有依据的,但这个依据值得核实一下:比如,会不会有另一个函数在同一条路径上更新了计数器。
打开指定的位置,或者在浏览器里重复一遍描述的操作。如果问题确实存在,可以把修复交给主智能体。如果不存在,把您的观察告诉它,请它重新核实结论。报告写得再漂亮,也代替不了对该改什么的判断。
"按给定标准没发现问题"这样的回答也是可以接受的,前提是能看清楚检查过什么。而"没找到实现删除逻辑的文件"意味着结果不完整:得先把路径说清楚。为了凑数量而在报告里瞎猜,没有意义。
顺便说一句,列表里可能还会出现内置角色 Explore 和 Plan。它们不用创建自己的角色文件就能用。
6. 什么时候值得委派
第一次检查顺利之后,很容易就想给每个动作都配一个独立助手。这种诱惑可以理解。但新开一次运行必须能带来点什么:一次独立的复核,或者一份不需要把详细过程带进主对话的独立工作。

| 任务 | 放在哪里做更合适 |
|---|---|
| 用明确标准检查一个已完成的功能 | 就算文件不大,独立的 reviewer 也有用:这里看重的是独立的视角 |
| 在很多文件里找一个值是从哪来的 | Subagent 能返回一份带路径的简短答案 |
| 改一个已知按钮的文案 | 在主对话里做:单独开一次运行几乎没有额外价值 |
| 和您一起逐步商量、确定行为 | 在主对话里更容易保留讨论的完整上下文 |
几个互相依赖的步骤,也可以合成一个交给 subagent 的任务。找到处理函数、检查它的调用、写出结论 - 这是一个正常的完整任务。不要把每一步都单独分给不同的助手,不然事后还得给每个人重新解释旁边那一步的结果。
Subagent 用的模型可以单独用 model 字段指定。现在还用不上:先拿到一个清晰的角色和可核实的结果更重要。单开一次运行本身,不代表模型会更强,也不代表会更弱。
第二个角色该检查不一样的东西
假设除了 reviewer,您还需要一个 playtester 来检查用户场景。把原来的指令复制一份、换个名字,基本改变不了什么。先把工作的对象和结果区分开:
| 角色 | 什么时候调用,传什么给它 | 能拿到什么 |
|---|---|---|
| reviewer | 需要检查删除功能的代码;传文件和要求 | 带位置、依据和限制说明的代码层面结论 |
| playtester | 需要评估用户场景;传步骤、预期和能拿到的观察结果 | 每一步发生了什么,结果在哪里跟预期不一样,还有什么没检查过 |
比如,一个角色可以只负责检查这一个场景:删除两件同名商品中的一件。操作之后应该剩下一条记录,计数器应该显示 1。这是一个可以量化的任务。"评估一下这个页面好不好"给主观评价留的空间太大了。
接下来把任务和工具对应起来。像我们这个 reviewer 一样只有读取和搜索能力的助手,没法在浏览器里执行操作。它能做的是拟一份检查场景,或者分析您记录下来的观察结果。这是检查前的准备或分析,不是独立完成的 playtest。
拟一份检查场景,用来验证删除两件同名商品中的一件。
每一步都要写明操作和预期结果。不要改代码,
不要声称已经执行过。
拿到我的观察结果之后,把预期和实际情况对比一下,
列出还缺哪些数据。
要独立完成运行,需要一个能用的浏览器操作工具,还得能确认运行确实发生过。光有 playtester 这个名字是不够的。先定好检查的方式,再在角色里写清楚什么时候调用它、它能如实返回什么样的结果。
7. 在您的会话里是什么样子
现在您已经有了一个会话能识别的角色文件,还有一项可以交给它的简短检查。作为起步,这已经够了。不用提前准备一堆差不多的 reviewer。
接下来该改哪一层,取决于问题出在哪里。漏传了重要条件 - 把任务补充完整。拿到了可疑的结论 - 核实一下依据。Reviewer 经常给出太笼统的回答 - 把角色指令写得更具体。文件会留在项目里,下一次检查就能直接从这些规则开始。
对于会反复用到的任务,给 reviewer 的任务书会有用。拿到回答之后,可以接着看怎么核实发现和选择修复方案。
GO TO FULL VERSION