工作了一个小时,智能体突然又提出半小时前您已经否掉的方案。或者复述一个您已经手动改过的文件。看起来像是健忘,但实际上这就是它的工作方式:智能体盯着一个大小有限的窗口,看到的不是整个项目,而只是落进这个窗口里的那部分内容。
我们来看看窗口里都占了些什么,怎样用命令 /context 查看,以及空间快用完的时候该怎么办。
上下文和它的边界
上下文是模型准备下一步时能拿到的信息:您的消息、智能体的回答、读过的代码、命令的输出、项目的指令。上下文窗口划定了这些信息同时能装下多少。它不是硬盘上的空闲空间,也不是您电脑的内存。
由此产生一个区别,也是最常引发混淆的地方。有三样东西很容易被当成一回事:
- 磁盘上的文件 - 项目的内容,能用工具读到;
- 保存下来的会话历史 - 对话的记录,存在磁盘上,能重新打开;
- 当前上下文 - 模型此刻手头实际拿到的东西。
这几样东西相关,但并不相同。文件可能一直放在文件夹里,却从未进入过对话。对话里也可能还留着半小时前那个版本的文件。所以"我们不是讨论过这个了吗"这句话本身,并不能说明智能体手上就是最新的信息。
- 项目文件
- 工具读取
- 用于回答的信息
文件存在,和智能体知道它,中间隔着读取这一步。Claude Code 会自己完成这一步:在项目里搜索,打开需要的内容,跳转到相关代码。不用您事先把每个路径都列出来。但只要这一步没做,对话里就没有这个文件。
所有这些的体量用 token 来衡量 - 模型把您的请求和读到的代码都切成的一个个小片段。一个 token 可能是完整的一个词,也可能只是词的一部分,所以按词数来数 token 是行不通的。
第一个问题之前,窗口就已经在被占用

还没等您打出第一个字,窗口就已经被占了。命令 /context 能显示具体占用情况:
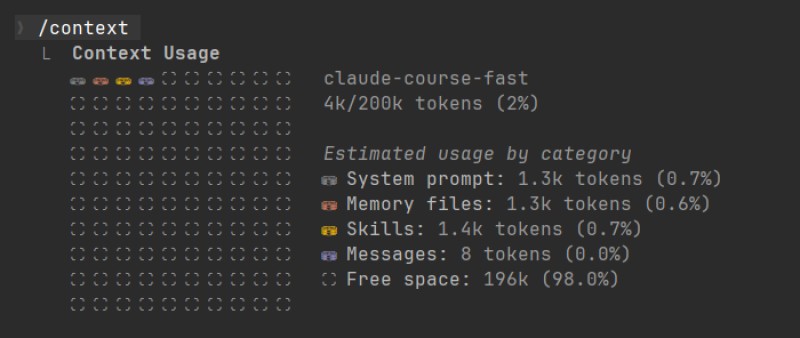
会话刚打开,200k token 里已经用掉了 4k,而且全是纯粹的系统开销:System prompt 是智能体自身的指令,Memory files 是加载进来的 CLAUDE.md 和项目规则,Skills 是可用 skill 的清单。Messages 这一行,也就是实际的对话内容,目前还是空的。
再看看工作一小时之后、还额外接了几个 MCP 服务器的情况:
/context

  System prompt     3.2k   ( 2%)   系统指令
  System tools     12.1k   ( 6%)   内置工具的说明
  MCP tools        21.4k   (11%)   已连接的外部服务器
  Memory files      1.8k   ( 1%)   CLAUDE.md、rules、auto memory
  Messages         45.2k   (22%)   您的对话、文件、日志
  Free space      116.3k   (58%)
这只是示意,不是某个具体版本的实际输出:行的组合和屏幕上的排布取决于您的 Claude Code 版本和项目里接了什么,窗口的大小则取决于模型。但整体格局大致都是这样,能从中得出几条实用结论:
- 基础开销 - 智能体自身的指令和内置工具的说明 - 始终存在,您也左右不了它;
- 每接入一个 MCP 服务器,窗口里至少会多出它的工具清单,哪怕您一次都没用过。抱着"先接上再说"的心态,就是在每个会话里都为此付费;
- 臃肿的
CLAUDE.md同样是每次启动都要重新付费的东西。这也是把它写短的一个理由; - 随着工作推进,实质上只有一行在持续变大 - 消息记录。盯着它就够了。
如果手边有 Claude Code:运行一次 /context,让它读一两个文件,再运行一次。消息那一行会当场明显变大,读一次文件到底要付出多少代价,一目了然。
工作过程中,窗口里会积累些什么
接下来窗口由您来填满 - 而且不只是文字。您让智能体读过、拿到过的一切,都会进入上下文:
| 来源 | 具体占用了什么 |
|---|---|
| 对话记录 | 您的消息、智能体的回答,包括被否掉的方案 |
| 读过的文件 | 整个内容,或者需要的那部分片段 |
| 工具的执行结果 | 命令的输出、搜索到的行、浏览器里观察到的内容 |
| skill 和 MCP 的材料 | 已经用上的 skill 的说明,调用过的工具的描述 |
请求本身和它换来的上下文,是两个很不一样的量。"把整个日志都发给我看看"这句话只有几个字,可它的结果能占上千行。这也是为什么一次庞大的输出,往往比一个长长的问题更伤窗口。
由此养成一个习惯:按需精确地提供来源。路径前面加个 @ 符号,就能把文件带进对话,输入路径的时候还有自动提示:读一下 @src/reward-flow.js,说说积分是在哪里算出来的。用 @ 提到一个文件夹,也不该理解成加载了它下面所有文件的内容:文件夹的引用给出的只是一份文件清单。按问题本身来挑选来源。文件和文件夹这两种引用之间的这个区别,官方文档里关于传递文件的部分说得很清楚。
再提一个小细节。如果您后来手动把十改成了二十,之前的回答不会自己跟着更新。请智能体在给出新的结果之前,先重新读一遍当前的内容。曾经读过一次的文件引用,不会让对话里那段旧文字变成磁盘上文件的实时副本。
空间用完的时候
窗口不会自己变大,但会话也不会说到一半就断掉。随着窗口被填满,Claude Code 会执行压缩:把详细的历史记录换成一份简短概述,腾出空间。这是自动完成的,具体在哪个时刻发生,取决于模型和设置。
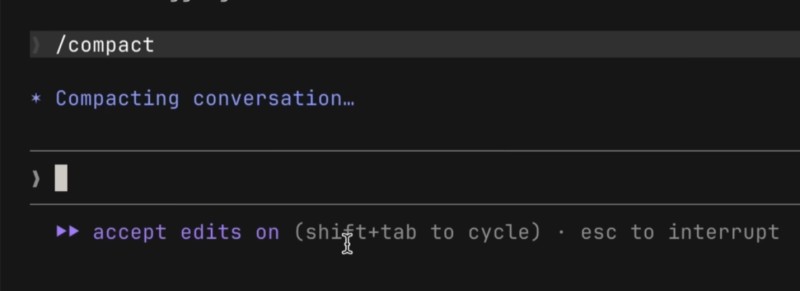
压缩也可以自己手动触发,用命令 /compact。手动触发的意义在于,您自己选时机 - 比如在一大块新工作开始之前 - 还能说明哪些内容一定要留下:
/compact 保留任务的目标和这次改动的边界,
保留曾经否掉的那个单独写处理函数的方案,
以及下一步:检查清空搜索框这个功能。
关于压缩最重要的一点:留在窗口里的是一份概述,不是原始对话。没有进入概述的细节,就已经离开了窗口,压缩之后再争论"你二十分钟前不是同意了吗"没有意义 - 更简单的办法是从文件里重新把这个事实找出来。不过项目的指令不会因此丢失:根目录的 CLAUDE.md 会重新加载一遍。
另一个命令 /clear 什么都不压缩。它打开一段新对话:旧的那段仍然保存着,可以通过 /resume 找到,项目文件不会变化,项目指令照常加载。
| 命令 | 做什么 | 什么时候选它 |
|---|---|---|
/context | 显示窗口被占用的情况 | 不清楚空间都花到哪去了 |
/compact | 把历史折叠成简短概述 | 任务没变,但历史积累了很多 |
/clear | 重新开始一段对话 | 任务换了 |
选择的原则很简单:任务不变就压缩,任务变了就开新对话。不用每条命令之后都清空一次,只要您还在处理同一个问题,之前积累的观察和补充说明都在为您服务。而在切换到新话题之前,把需要的结论写成一两行会很有用:"奖励在 src/reward-config.js 里定义,发放在 src/reward-flow.js 里"。这是一个能带您回去的提示,不用把整段对话重新写一遍。

怎样更省着用窗口
只要窗口从一开始就没被无关内容塞满,这三条命令就用不着那么频繁。以下几个习惯收益最大:
- 问得具体一点。模糊的请求会逼着智能体去做一轮侦查:读多余的文件,试各种方案。点明具体文件、说清楚预期,既省空间也省时间。
- 不要一股脑全倒出来。要弄清楚一个测试为什么失败,需要的是报错周围的那几行,不是整份日志。
- 让项目指令保持简短。
CLAUDE.md在每个会话里都会被加载一遍。大段的参考资料更适合放进单独的文件,按需再读。 - 关掉用不上的 MCP 服务器。抱着"留着以防万一"心态接入的服务器,每次启动都占地方,却什么用都没派上。
- 大规模调研交给 subagent。它在自己的窗口里干活,只把总结带回来,几十个读过的文件都留在它自己那边。
要记住的几点
上下文是您放到桌上的那部分东西,不是"项目里有的"那部分。磁盘上的文件、历史记录里的条目和当前窗口里的信息,是三件不同的事,混淆它们能解释大部分莫名其妙的回答。
接下来一切都归结为三个动作:用 /context 看看填得怎么样了,用 @ 给出需要的来源,再及时决定是压缩对话还是重开一个。按情况选 - 压缩替代不了读一个真正需要的文件,给出的文件也不会替您检查智能体的推理。
GO TO FULL VERSION