几乎每个学 Python 的人都至少踩过一次这个坑。你写下 numbers = numbers.sort(),一运行——numbers 变成了 None。列表好像排好序了,然后就不见了。
这不怪 Python,它只是照你说的做了。sort 和 sorted 看起来像双胞胎,行为却不一样。我们一次把它讲透——顺便把实际工作中会遇到的情况都过一遍:key、字典、对象、多字段、中文和速度。
sorted() 和 sort() 有什么区别
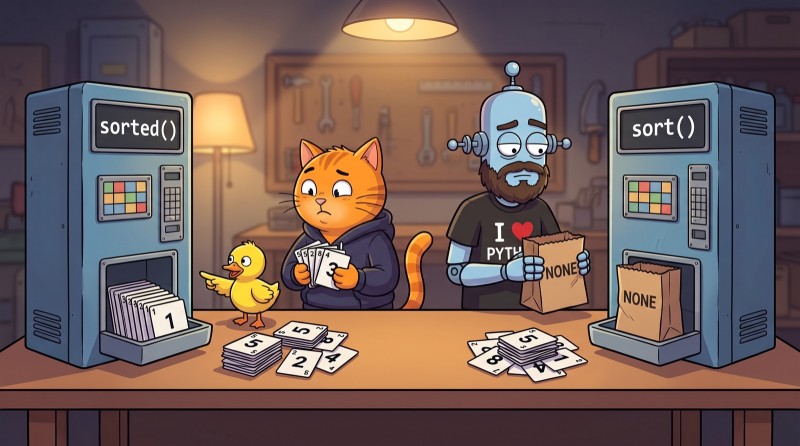
简单来说:sorted() 是一个函数,它返回一个新的已排序列表,不改动原始数据。list.sort() 是列表的方法,它原地排序,并返回 None。
scores = [42, 7, 19]

fresh = sorted(scores)
print(scores)  # [42, 7, 19] — 原列表没有变
print(fresh)   # [7, 19, 42] — 这是一个新列表

fresh = scores.sort()
print(scores)  # [7, 19, 42] — 这次是列表本身变了
print(fresh)   # None
开头那个 bug 的谜底就在这里:.sort() 排好了序,返回了 None——然后这个 None 覆盖了你的变量。返回 None 是 Python 的有意设计:会修改对象的方法什么都不返回,免得有人把它和创建副本的函数搞混。
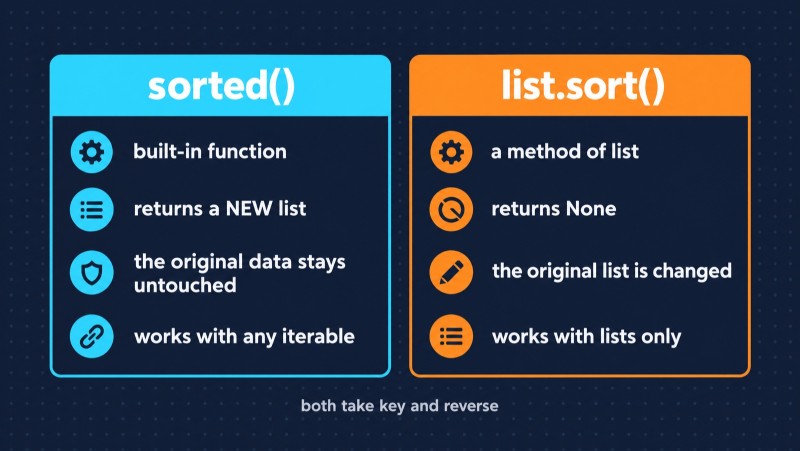
sorted() | list.sort() | |
| 是什么 | 内置函数 | 列表方法 |
| 返回值 | 新列表 | None |
| 原始数据 | 不变 | 被修改 |
| 适用对象 | 任何可迭代对象:列表、元组、字符串、字典、集合 | 只有列表 |
| 什么时候用 | 需要保留原数据,或者手里不是列表 | 列表很大,且不需要原数据 |
一个重要细节:不管你传什么进去,sorted() 返回的永远是列表。
sorted((3, 1, 2))       # [1, 2, 3] — 传入元组,得到列表
sorted("python")        # ['h', 'n', 'o', 'p', 't', 'y']
"".join(sorted("python"))  # 'hnopty'
降序排序:reverse
两者的参数相同:key 和 reverse。它们只能按名字传入——numbers.sort(True) 会抛出 TypeError。
cities = ["Shanghai", "Beijing", "Shenzhen"]

sorted(cities)                # ['Beijing', 'Shanghai', 'Shenzhen']
sorted(cities, reverse=True)  # ['Shenzhen', 'Shanghai', 'Beijing']
按 key 排序:key 参数
key 是排序中最重要的参数。你传入一个函数,Python 会对每个元素调用它,并按它的返回值排序。元素本身不会被修改。
我们拿一个员工列表来演示,后面都会用到它:
employees = [
    {"name": "Wang", "dept": "Dev", "salary": 4200},
    {"name": "Liu", "dept": "QA", "salary": 2600},
    {"name": "Zhao", "dept": "Dev", "salary": 3100},
    {"name": "Sun", "dept": "Design", "salary": 2900},
]
lambda——快速写 key
by_salary = sorted(employees, key=lambda e: e["salary"])itemgetter 和 attrgetter——效果一样,但更快
operator 模块里有现成的函数,可以取字典字段或对象属性。它们是用 C 写的,所以比 lambda 更快。
from operator import itemgetter

by_salary = sorted(employees, key=itemgetter("salary"))
快多少?我们在最新的 Python 3.15 上用十万个字典测了一下:itemgetter 比 lambda 快约 10%。不错,但谈不上革命——短列表上你根本感觉不到差别。大量、频繁排序时用 itemgetter,可读性更重要时用 lambda。
现成的函数和方法
key 可以接收任何单参数函数,包括内置函数。关键是传函数本身,不要加括号。
words = ["banana", "kiwi", "Cherry"]

sorted(words)                 # ['Cherry', 'banana', 'kiwi'] — 大写字母排在前面
sorted(words, key=str.lower)  # ['banana', 'Cherry', 'kiwi'] — 忽略大小写
sorted(words, key=len)        # ['kiwi', 'banana', 'Cherry'] — 按长度
按多个字段排序
用元组作 key
如果 key 返回一个元组,Python 会逐个元素比较:先比第一个值,相等时再比第二个,依此类推。想让某个数值字段降序排列,就在它前面加个负号。
# 先按部门排,部门内按工资从高到低
result = sorted(employees, key=lambda e: (e["dept"], -e["salary"]))
两次排序——加不了负号时
负号只对数字有效。如果要把字符串降序排列,就得靠稳定性:Python 的排序永远不会改变 key 相同元素的相对顺序。所以可以分两次排序——先按次要字段,再按主要字段。
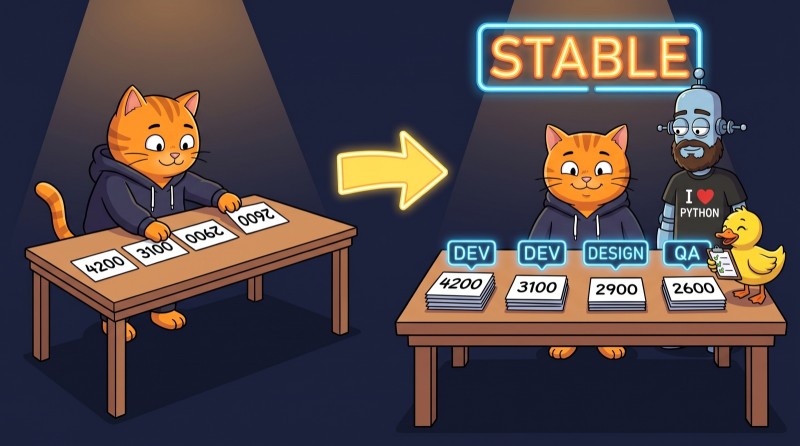
from operator import itemgetter

# 1. 次要字段:工资降序
step1 = sorted(employees, key=itemgetter("salary"), reverse=True)
# 2. 主要字段:部门按字母顺序——部门内的工资顺序会保留下来
result = sorted(step1, key=itemgetter("dept"))
一般认为元组更快,因为只排一次。我们用同样的十万个字典验证了一下——结果用 itemgetter 排两次,反而比用 lambda 的元组快了大约一半:16 毫秒对 27 毫秒。创建十万个元组再逐个元素比较,也是有成本的。结论很简单:选读起来更清楚的写法,等测量真的发现问题时再考虑速度。
如何按值对字典排序
字典本身没法排序,但你可以拿到排好序的键或键值对,再用它们构造一个新字典——从 Python 3.7 开始,字典会保持插入顺序。
grades = {"Wang": 72, "Chen": 95, "Li": 88}

sorted(grades)  # ['Chen', 'Li', 'Wang'] — 只有键

# 按值从大到小
top = dict(sorted(grades.items(), key=lambda kv: kv[1], reverse=True))
print(top)  # {'Chen': 95, 'Li': 88, 'Wang': 72}
只需要前 N 个?别全部排序
一个常见任务:找出最大的 10 个值。第一反应是排序后取切片。但为了十个元素去排一百万个,太浪费了。这正是 heapq 模块的用武之地:
import heapq

top10 = heapq.nlargest(10, numbers)
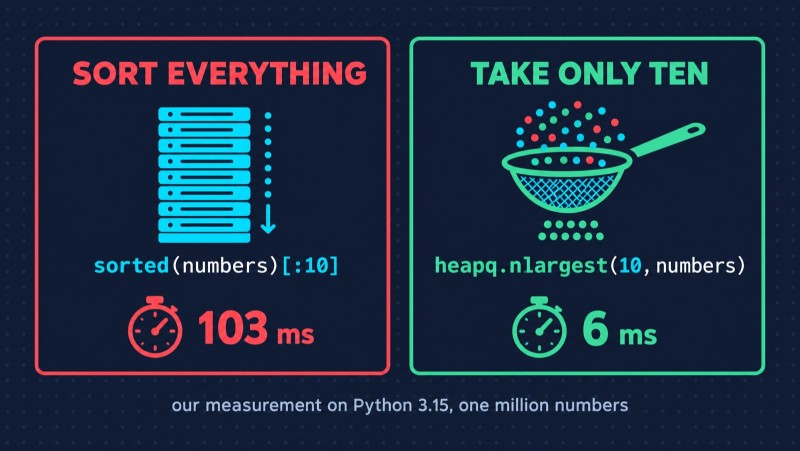
cheapest = heapq.nsmallest(3, products, key=lambda p: p["price"])在我们对一百万个数字的测试中,heapq.nlargest(10, ...) 比 sorted(...)[:10] 快了将近 18 倍:6 毫秒对 103 毫秒。
对象排序
如果数据放在对象里,key 的写法一样,只是换成 attrgetter:
from dataclasses import dataclass
from operator import attrgetter

@dataclass
class Employee:
    name: str
    salary: int

staff = [Employee("Wang", 4200), Employee("Liu", 2600)]
sorted(staff, key=attrgetter("salary"))
如果对象总是要按同一种方式排序,那就教它们自己比较:对 dataclass 来说,@dataclass(order=True) 就够了——比较会按字段声明的顺序进行。
让排序出错的五个陷阱
1. 列表里有 None
sorted([3, None, 1])
# TypeError: '<' not supported between instances of 'NoneType' and 'int'
Python 3 不能把 None 和数字作比较。解决办法是写一个把 None 放到最后的 key:
sorted([3, None, 1], key=lambda x: (x is None, x)) # [1, 3, None]2. 类型混杂
sorted([3, "2", 1]) 会因为同样的错误失败:字符串没法和数字比较。这通常说明数据是“脏”的,比如来自 CSV。在排序之前先统一类型,而不是在排序过程中处理。
3. 字符串里的数字
files = ["file10.txt", "file2.txt", "file1.txt"]
sorted(files)  # ['file1.txt', 'file10.txt', 'file2.txt']
字符串是逐字符比较的,“10”里的“1”比“2”小。要得到人习惯的顺序——也就是所谓的自然排序——就把字符串拆成文本和数字:
import re

def natural_key(s):
    return [int(part) if part.isdigit() else part.lower()
            for part in re.split(r"(\d+)", s)]

sorted(files, key=natural_key)  # ['file1.txt', 'file2.txt', 'file10.txt']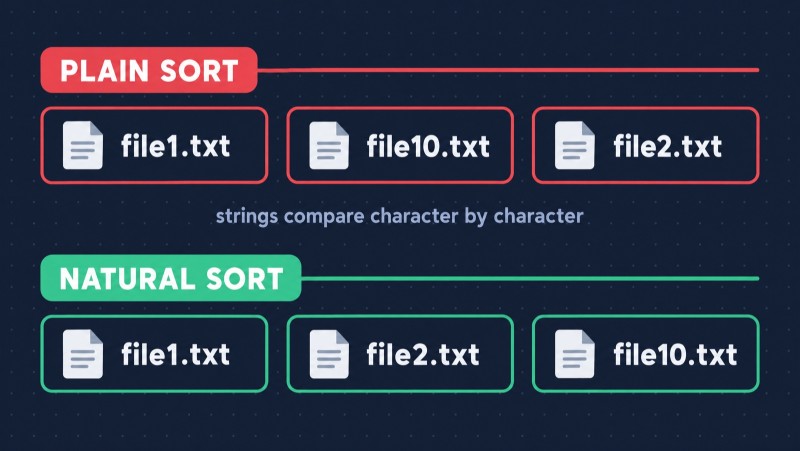
4. 中文排序
再来一个英文教程里不会提的陷阱:
sorted(["赵磊", "王芳", "张伟", "李娜"]) # ['张伟', '李娜', '王芳', '赵磊']结果看起来像是排好了,其实既不是按拼音,也不是按笔画。Python 按 Unicode 码位比较字符串,而汉字在码表里的顺序和拼音顺序毫无关系。按拼音排,正确的顺序应该是:李娜、王芳、张伟、赵磊。
要按拼音排序,最简单的办法是 pypinyin 库:
from pypinyin import lazy_pinyin

sorted(["赵磊", "王芳", "张伟", "李娜"], key=lazy_pinyin)  # ['李娜', '王芳', '张伟', '赵磊']
也可以用 locale 模块配合 zh_CN.UTF-8,但结果取决于系统里装了哪些 locale,在 Windows 上名字也不一样。如果生产环境需要稳定的中文排序,更可靠的是 PyICU 或 pypinyin——它们在哪里表现都一样。
5. 把 sort 的结果赋值给变量
就是开头那个 bug。x = x.sort() 永远是 None。要么单独一行写 x.sort(),要么写 x = sorted(x)。
底层原理
Python 的排序不是教科书里的冒泡排序,而是一种针对真实数据优化的混合算法。从 2.3 版开始用的是 Timsort,到了 Python 3.11,它的合并策略被替换成了 Powersort——更稳健,而且有经过证明的性能保证。
实践中需要知道的:
- 最坏情况下的复杂度是 O(n log n)。
- 排序是稳定的,这一点由官方文档保证。两次排序的技巧正是建立在这个基础上。
- 几乎有序的数据排得非常快。 算法会找出已经有序的片段,然后直接把它们合并。在我们的测试中,已排好序的一百万个数字,排序速度比打乱的快约 9 倍。

所有测量都是在 Python 3.15.1、Apple Silicon 笔记本上完成的。换一台机器,绝对数值会不同,但比例关系通常不变。想自己验证?timeit 模块加五行代码就够了。
既然代码让 AI 来写,为什么还要懂这些
问得好。让任何一个 AI 按工资给字典列表排序,一秒钟就能拿到能跑的代码。但 AI 也会同样自信地写出 data = data.sort(),想不到数据库里来的 None,还会把中文姓名排错顺序。代码看起来没问题,粗看一眼也能过关。
只有真正懂排序原理的人才能发现这种错误。这就是“用 AI 的人”和“被 AI 放大好几倍的人”之间的差别:工具只会让有基础的人更快。
Python 的基础要靠练,不是靠读。CodeGym 的 Python 课程 有 52 个以上的等级,所有任务即时判题,另外还有专门讲算法和数据结构的等级——在那里,排序会被从里到外拆开讲,而不只是“调用 sorted”。如果你还不知道整体该怎么学 Python,可以看看我们的 2026 年 Python 开发者路线图。
常见问题
Python 中 sort() 和 sorted() 有什么区别? sorted() 是内置函数:接收任何可迭代对象,返回一个新的已排序列表,不修改原始数据。list.sort() 是列表方法:原地排序并返回 None。
为什么 list.sort() 返回 None? 这是 Python 的有意设计:原地修改对象的方法返回 None,以免和创建新对象的函数混淆。所以 x = x.sort() 会把 None 存进变量。
Python 如何对列表降序排序? 传入参数 reverse=True:sorted(data, reverse=True) 或 data.sort(reverse=True)。
Python 如何按值对字典排序? 按第二个元素对键值对排序,再构造新字典:dict(sorted(d.items(), key=lambda kv: kv[1]))。要降序就加上 reverse=True。
如何按多个字段对列表排序? 给 key 传一个返回元组的函数:key=lambda e: (e["dept"], -e["salary"])。如果某个字段没法用负号反转(比如字符串),就分两次排序:先按次要字段,再按主要字段——排序的稳定性会保留顺序。
Python 用的是什么排序算法? 3.10 及以前的版本用 Timsort,从 Python 3.11 开始用它的改进版 Powersort。两者都是混合、稳定的算法,复杂度为 O(n log n),在部分有序的数据上尤其快。
GO TO FULL VERSION