通过 API 调用 GPT-5.5,一百万个输出 token 要 30 美元。Claude Sonnet 5.5 要 10 美元。DeepSeek V4.1 Flash 只要 0.60 美元起。
这不是笔误。差距是几十倍。不仅如此,DeepSeek 的模型可以完整下载,部署在你自己的服务器上,因为它的权重以 MIT 许可证公开。明天就能集成进产品。
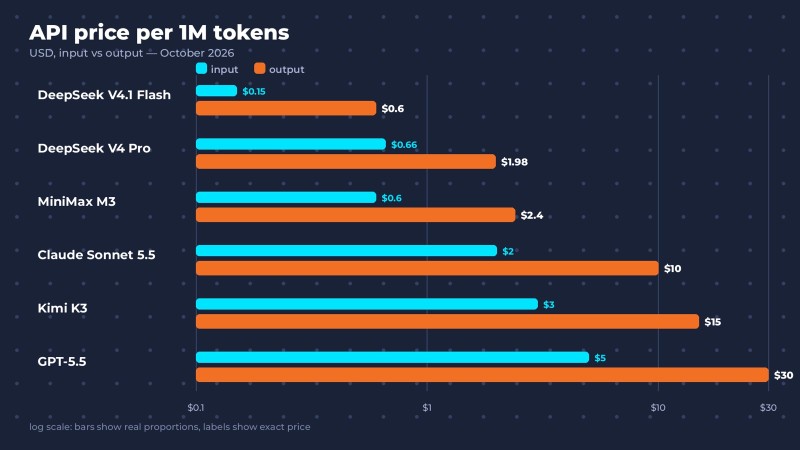
听起来像社交媒体上的骗局广告。但这就是 2026 年的现实:中国实验室几乎每个月都会发布达到西方旗舰水平的模型,而且免费开放。全世界的开发者已经在用了。
我们来看看这些模型是什么、真正能做什么、怎么接入 Claude Code——以及坑在哪里。坑是有的,而且不止一个。
什么是开放模型,为什么重要
简单来说:开放模型(open-weight)是权重公开可下载的神经网络。你可以在自己的硬件上运行它,针对自己的任务微调,并把它集成进产品——不需要订阅,也不用把数据发到别人的云上。
ChatGPT 和 Claude 是闭源模型。你只能通过网站、应用或 API 使用它们,模型本身运行在 OpenAI 和 Anthropic 的服务器上。开放模型则可以真正归你所有:下载下来,就是你的,按你的条件使用。至于有多大程度归你,要看许可证——后面会讲。
中国公司为什么免费开放模型
几年前,提到开放模型,大家首先想到的是 Meta 的 Llama。到了 2026 年,格局变了。根据 Hugging Face 的春季报告,2025 年 2 月到 2026 年 2 月,平台上 41% 的下载量来自中国开放模型,美国模型占 36.5%。
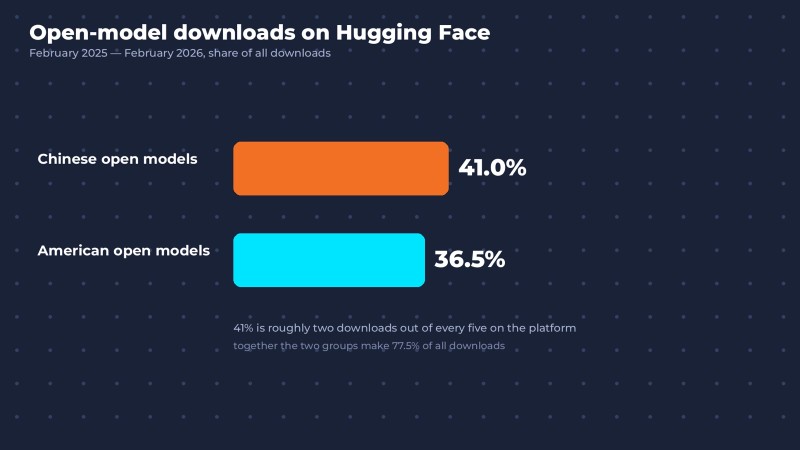
据多方估计,阿里巴巴的 Qwen 系列下载量已突破十亿次,超过了 Llama。基于它微调出的衍生模型,比任何其他系列都多。
为什么中国公司要免费放出 OpenAI 和 Anthropic 收费的东西?原因有几个:
- 这是抢占市场的策略。 当全世界的开发者都在你的模型上做产品,你就成了标准。钱随后会从云服务、企业客户和下一代模型中赚回来。
- 中国国内的竞争。 DeepSeek、阿里巴巴、月之暗面、智谱、MiniMax 和字节跳动之间竞争极其激烈,几乎每周都有人发布新版本。
- 训练成本下降了。 中国实验室学会了用更低的成本训练强大的模型,包括在美国芯片供应受限的情况下。
对开发者来说,结论很简单:2026 年可选的模型比以往任何时候都多,而且其中一部分是免费的。
2026 年主要的中国大模型
先说一个重要的前提。这里的版本更新太快,任何评测几个月就会过时。以下是截至 2026 年 10 月底的情况。
DeepSeek V4:最便宜的 API
就是那家在 2025 年 1 月让英伟达股价暴跌的公司。DeepSeek 现在有两个主力模型:V4 Pro 和 V4.1 Flash。最新版 Flash 于 2026 年 10 月 17 日发布,权重以 MIT 许可证开放,上下文最长一百万 token。
优势是价格。Flash 比西方旗舰便宜几十倍,在非高峰时段还能再便宜一半左右。做后台自动化、文档处理和批量任务,几乎等于免费。
劣势是复杂智能体任务中的可靠性。Tom's Hardware 在评测新模型时特别指出:它很节省显存,但在智能体场景下比闭源竞品更容易产生幻觉。

Qwen 3.8:最受欢迎的开放模型
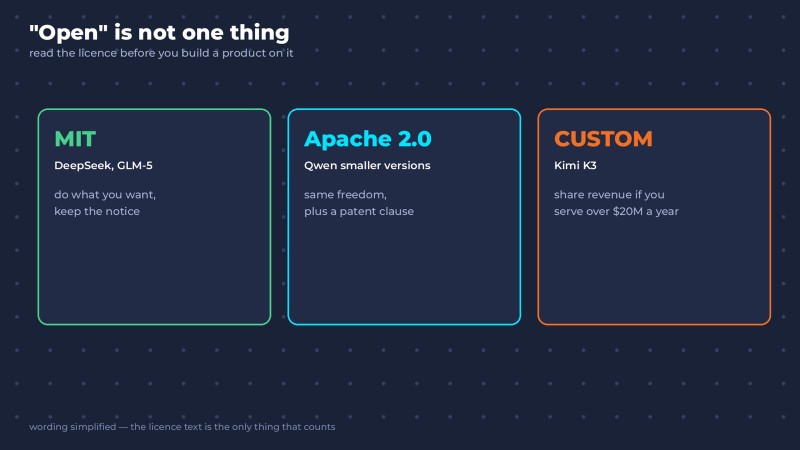
阿里巴巴的模型系列。当前一代是 Qwen 3.8,据阿里巴巴称,Qwen 4 正在训练中。Qwen 最大的优点是尺寸选择丰富:从能在自己电脑上真正跑起来的小模型,到重量级旗舰。小版本采用 Apache 2.0 许可证,是最宽松的许可证之一。
如果你需要一个能针对自己任务微调的开放模型,Qwen 是首选。正因如此,基于它的衍生模型最多。
Kimi K3:面向代码和智能体的旗舰
月之暗面(Moonshot AI)出品。K3 于 2026 年 7 月 16 日发布,两周后月之暗面公开了权重。规模惊人:2.8 万亿参数,上下文一百万 token。它专为长时间的智能体任务设计:在大型仓库中导航、调试、使用工具和分析日志。
Kimi 之前就上过新闻:最近它在 27 分钟内找到了 Redis 中的一个远程代码执行漏洞。
需要注意的是许可证。它不是 MIT,而是自定义许可证:通过 K3 推理每年收入超过 2000 万美元的服务商需要分成。作为开发者你大概率不受影响,但在产品中使用模型之前,许可证一定要读。
GLM-5:面向编程的开放模型
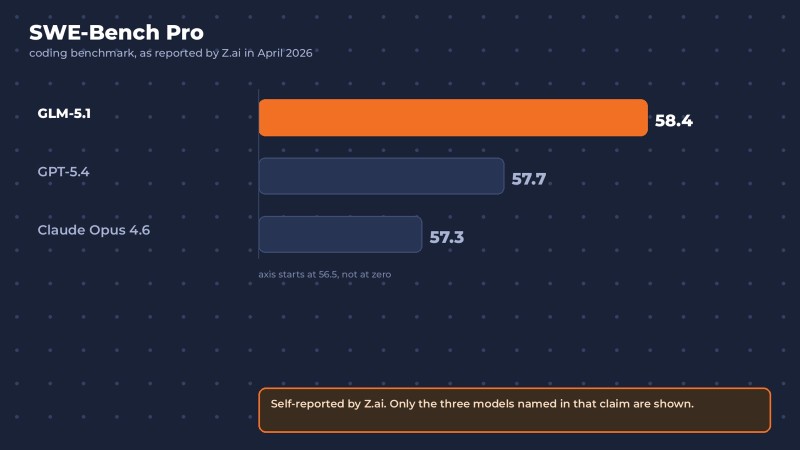
智谱 AI(现更名为 Z.ai)的模型系列。2026 年 4 月,公司以 MIT 许可证开放了 GLM-5.1 的权重。按 Z.ai 自己的测试,该模型在 SWE-Bench Pro 基准上排名第一,超过了 GPT-5.4 和 Claude Opus 4.6。需要说明的是:这个结果由公司自行公布,而且此后 Z.ai 又发布了几个新版本——这里的更新几乎是每月一次。
面向开发者,Z.ai 还提供 GLM Coding Plan——每月 18 美元起的订阅,可以直接在 Claude Code 里使用。后面会详细讲。
MiniMax M3:百万上下文与多模态
MiniMax 出品,2026 年夏天发布,权重开放。公司押注在一个模型里结合三件事:强大的编程能力、一百万 token 的上下文,以及原生的图像理解。需要一次性喂给模型大量文档或代码时,它是不错的选择。
Seedream 和 Seedance:字节跳动的图像和视频
中国公司不只在文本模型上强。做出抖音和 TikTok 的字节跳动,推出的图像和视频生成器能和西方最好的产品一较高下。
Seedream 5.0 是图像生成器。字节跳动在 2026 年 2 月发布了它,定位是比谷歌 Nano Banana Pro 更便宜的替代品,夏天又推出了 Pro 版本。它能生成 2K 和 4K 图像,可以根据参考图编辑图片,轻量版甚至会在生成前先联网搜索信息。通过 OpenRouter,Seedream 5.0 Pro 生成一张图约 0.045 美元。
Seedance 2.0 是视频生成器。从 2026 年春天起,它直接集成在剪映海外版 CapCut 和 Dreamina 中,Dreamina 上已经有 2.5 版本,可以生成最长 30 秒的视频。开发者可以通过 BytePlus 调用 API。
这和开发者有什么关系?因为产品不只是代码。图标、落地页插图、游戏素材、上线用的演示视频——以前这些都需要设计师、剪辑师和预算。现在一个晚上就能做出第一版。一个人加上代码和这些工具,就能完成过去需要一个小团队才能做的事。
对比:该选哪个模型
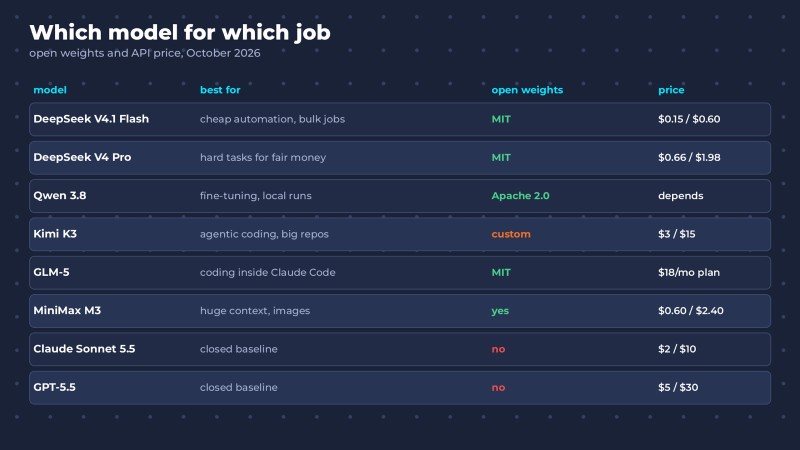
| 模型 | 最适合 | 开放权重 | API 价格(每百万 token,输入 / 输出) |
| DeepSeek V4.1 Flash | 低成本自动化、批量任务 | 是,MIT | 0.15 / 0.60 美元起 |
| DeepSeek V4 Pro | 以适中价格处理难题 | 是,MIT | 约 0.66 / 1.98 美元 |
| Qwen 3.8 | 微调、本地运行、尺寸可选 | 是,小版本采用 Apache 2.0 | 取决于尺寸和服务商 |
| Kimi K3 | 智能体编程、大型仓库 | 是,自定义许可证 | 3 / 15 美元 |
| GLM-5 | 编程、在 Claude Code 中使用 | 是,MIT | Coding Plan 每月 18 美元起 |
| MiniMax M3 | 超大上下文、图像 + 代码 | 是 | 约 0.60 / 2.40 美元 |
| 对比:Claude Sonnet 5.5 | — | 否 | 2 / 10 美元 |
| 对比:GPT-5.5 | — | 否 | 5 / 30 美元 |
中国服务商的价格变动频繁,常有上线折扣,高峰和非高峰时段的价格也不同。在把成本算进产品之前,请以官方价格页为准。
怎样在 Claude Code 里使用中国大模型
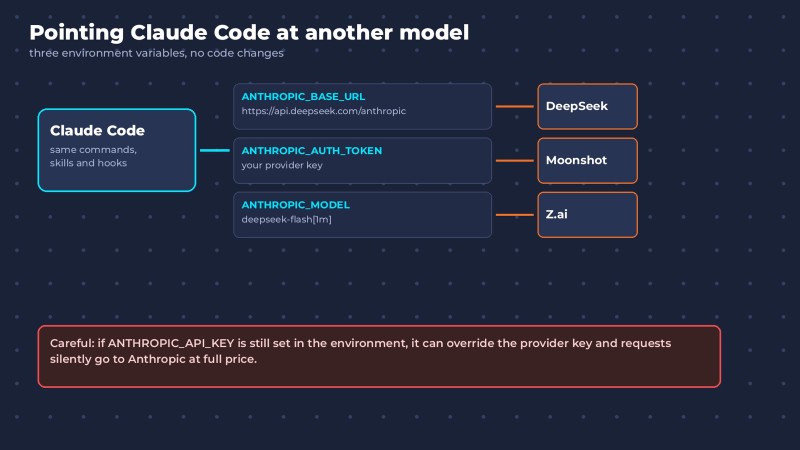
接下来是最实用的部分。Claude Code 不只能用 Claude 模型。它会把请求发到环境变量 ANTHROPIC_BASE_URL 指定的地址,而 DeepSeek、月之暗面和 Z.ai 都提供了兼容 Anthropic 格式的 API。
下面是 DeepSeek 官方文档里的配置:
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=<你的 DeepSeek API 密钥>
export ANTHROPIC_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
claude
后缀 [1m] 用于开启一百万 token 的上下文。如果配置里保留 Claude 的模型名,DeepSeek 会自动转发请求:Opus 转到 V4 Pro,Sonnet 和 Haiku 转到 Flash。
之后 Claude Code 照常工作——同样的命令、同样的 Skills、同样的子智能体——只是负责思考的变成了 DeepSeek。月之暗面的 Kimi K3 和 Z.ai 的 GLM 也是同样的方式:各自的 API 地址和各自的密钥。
有三件事最好提前知道:
- 这不是 Anthropic 官方支持的配置。 它由中国服务商自己提供文档。有些功能可能表现不同:比如中国模型不会出现在
/model菜单里,想确认当前是哪个模型在回答,可以用/status。 - 注意
ANTHROPIC_API_KEY变量。 如果它还留在环境里,可能会覆盖服务商的密钥,请求会悄悄发到 Anthropic,并按全价计费。 - 效果会有差别。 Claude Code 是针对 Claude 模型调优的。简单任务几乎看不出区别,长时间的智能体会话里差别就明显了。
智能体本身、Skills、子智能体和钩子是怎么工作的,我们在 AI 智能体是如何工作的 一文中详细讲过。
坑在哪里
吹捧式评测通常讲到这里就结束了。我们不会。在把工作迁移到中国大模型之前,有四件事值得想清楚。
1. “本地部署”不等于在笔记本上跑
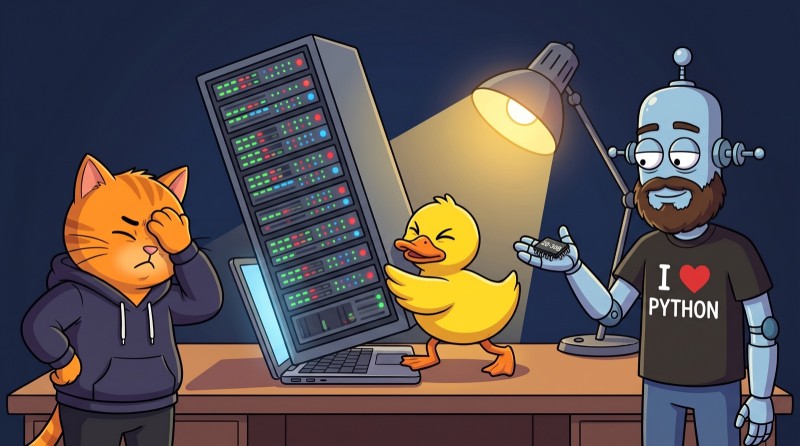
评测很喜欢说,中国大模型可以通过 Ollama 或 LM Studio 直接在自己电脑上运行。技术上没错,实际上只适用于小版本。旗舰 GLM-5.1 约有 7440 亿参数,Kimi K3 有 2.8 万亿。要跑这种规模,需要的不是笔记本,而是装着多块昂贵显卡的服务器机柜。
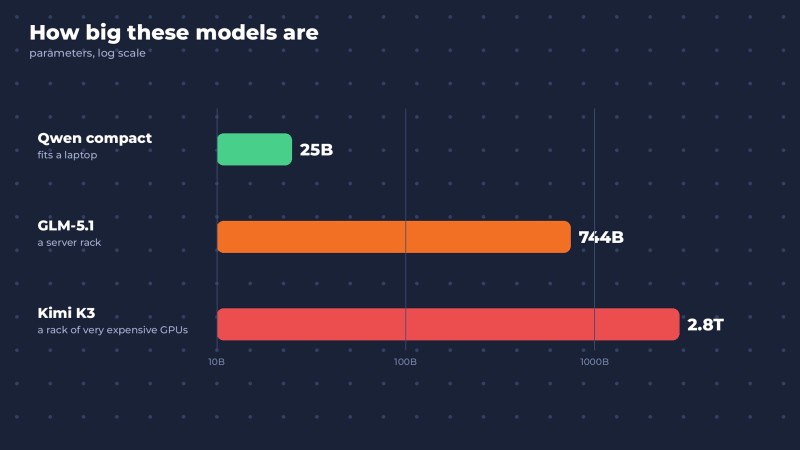
普通电脑上真正能跑的是蒸馏过的小模型——比如 200 亿到 300 亿参数的 Qwen 小版本。它们有用,但达不到旗舰水平。
2. 你的数据去了哪里
在自己服务器上运行开放模型是一回事,调用中国公司的云端 API 是另一回事。DeepSeek 的隐私政策明确写着,请求和上传的文件存储在中国境内的服务器上。正因为如此,澳大利亚禁止在政府设备上使用 DeepSeek,意大利监管机构要求从应用商店下架该应用,捷克和台湾地区也禁止政府机构使用。
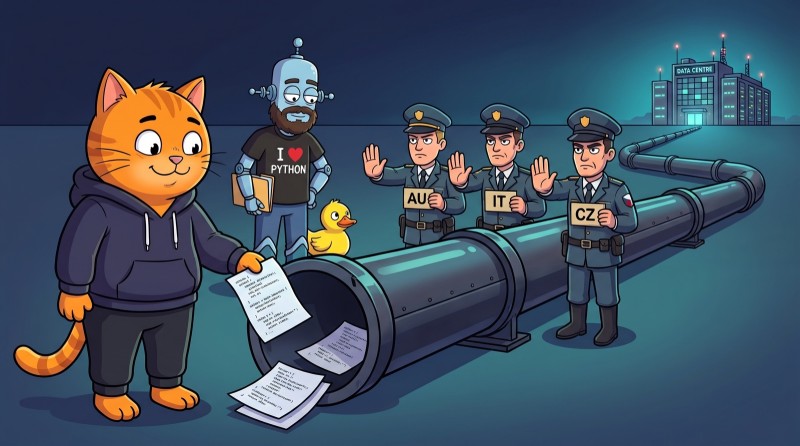
一条实用的规则:个人业余项目用云端 API 没问题。公司的代码、密钥和客户数据——只用本地部署,或者交给自己托管开放权重的海外服务商。权重是同一份,但数据始终在你的掌控之中。
3. AI 垃圾内容并没有消失
便宜的模型犯错不会比贵的少,有时反而更多。在复杂逻辑和长时间智能体任务中,中国大模型明显更容易自信地给出跑不通的代码,或者编造不存在的方法。各家公司自己公布的基准成绩要打个折看:它们测的是方便测的东西。
4. “开放”不等于“随便用”
MIT 和 Apache 2.0 确实是宽松的许可证。但 Kimi K3 用的是自定义许可证,对大型商业服务商有附加条件。在模型之上做产品之前,花十分钟读一下许可证。这比以后推倒重来便宜得多。
这对开发者意味着什么
有一个我们反复强调的老观点:工具会归零,基础会留下。中国大模型把这一点展现得最清楚。
一年前,能用上强大的模型还是一种优势。现在,旗舰级模型可以免费拿到,一个月后还会有下一个——也是免费的。模型正在变成像电一样的基础资源。没有人会因为自家插座里有电而自豪。
价值正在转向那些会用电的人。根据任务和预算选模型。把它接入智能体。检查它写了什么——并发现它在哪里自信地犯了错。设置好权限,别让智能体闯祸。这才是值钱的技能。而且它不会因为新模型发布而贬值——恰恰相反,它会越来越值钱。
最好的模型,不是在基准排行榜上最靠前的那个,而是你能验证其结果的那个。

在哪里学
用一种不依赖任何单一模型的方式和智能体协作——这正是我们 AI Academy 的 用 Claude Code 开发 课程要教的。16 个等级、200+ 道任务:权限与上下文、Skills、子智能体、MCP、钩子、plan mode,以及通过 git 掌控一切。无论底层用的是哪个模型,这些都一样适用。
如果你刚开始学编程,就从基础学起:要检查模型写的代码,你自己得会读代码。我们的 Python 课程 正是为此而设,有数千道即时判题的任务。
常见问题
2026 年最好的中国大模型有哪些? 截至 2026 年 10 月底,主要有:DeepSeek V4(最便宜的 API)、阿里巴巴的 Qwen 3.8(最受欢迎的开放模型)、月之暗面的 Kimi K3(智能体编程和大型仓库)、Z.ai 的 GLM-5 系列(编程、在 Claude Code 中使用)以及 MiniMax M3(百万 token 上下文和多模态)。图像和视频方面有字节跳动的 Seedream 5.0 和 Seedance 2.0。
中国大模型能替代 ChatGPT 和 Claude 吗? 在很多任务上可以:自动化、文档处理、中等复杂度的代码生成。在复杂逻辑和长时间的智能体场景中,中国大模型目前出错更多。主要优势是 API 价格低几十倍,并且可以在自己的服务器上运行。
中国大模型的 API 多少钱? DeepSeek V4.1 Flash 每百万输入 token 0.15 美元起,每百万输出 token 0.60 美元起。Kimi K3 分别是 3 美元和 15 美元。作为对比:Claude Sonnet 5.5 是 2 美元和 10 美元,GPT-5.5 是 5 美元和 30 美元。价格经常变动,请以服务商官方页面为准。
可以在自己的电脑上运行中国大模型吗? 只能运行小版本——比如通过 Ollama 或 LM Studio 运行 200 亿到 300 亿参数的 Qwen 小模型。GLM-5.1(约 7440 亿参数)或 Kimi K3(2.8 万亿参数)这样的旗舰,需要配备多块高性能显卡的服务器硬件。
把代码发给中国大模型安全吗? 通过云端 API 要谨慎:比如 DeepSeek 会把请求和文件存储在中国境内的服务器上,因此一些国家禁止在政府设备上使用它。对于公司代码和客户数据,更稳妥的做法是在本地运行开放权重,或者使用自行托管这些权重的海外服务商。
怎样在 Claude Code 中使用 DeepSeek 或 Kimi? 通过环境变量:把 ANTHROPIC_BASE_URL 设为服务商兼容 Anthropic 的地址(例如 https://api.deepseek.com/anthropic),在 ANTHROPIC_AUTH_TOKEN 中填入服务商的密钥,在 ANTHROPIC_MODEL 中填入模型名。这是服务商提供文档、但 Anthropic 官方不支持的配置。
GO TO FULL VERSION