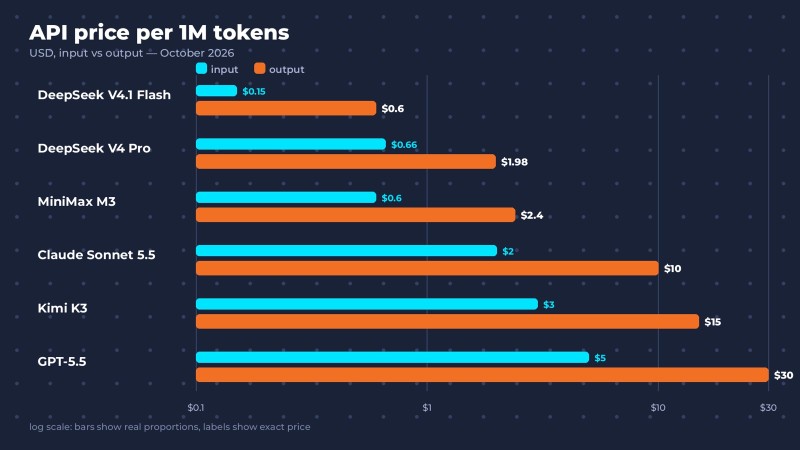
Un millón de tokens de salida de GPT-5.5 por API cuesta 30 $. En Claude Sonnet 5.5, 10 $. En DeepSeek V4.1 Flash, desde 0,60 $.
No es una errata. La diferencia es de decenas de veces. Además, el modelo de DeepSeek se puede descargar completo y ejecutar en tu propio servidor, porque sus pesos están publicados bajo licencia MIT. Podrías integrarlo en un producto mañana mismo.
Suena a estafa de anuncio en redes sociales. Pero es la realidad de 2026: los laboratorios chinos lanzan casi cada mes modelos al nivel de los buques insignia occidentales y los regalan. Desarrolladores de todo el mundo ya los están usando.
Veamos qué son estos modelos, de qué son capaces de verdad, cómo conectarlos a Claude Code y dónde empieza la trampa. La hay, y no solo una.
Qué son los modelos abiertos y por qué importan
En resumen: un modelo abierto (open-weight) es una red neuronal cuyos pesos se publican para descargarlos. Puedes ejecutarlo en tu propio hardware, ajustarlo a tu tarea e integrarlo en un producto sin suscripción y sin enviar datos a la nube de otro.
ChatGPT y Claude son modelos cerrados. Solo los usas a través de una web, una app o una API, y el modelo vive en los servidores de OpenAI y Anthropic. Un modelo abierto lo puedes tener en propiedad: lo descargas y es tuyo, con tus condiciones. Hasta qué punto es tuyo depende de la licencia, pero de eso hablamos más abajo.
Por qué China regala sus modelos
Hace un par de años, los modelos abiertos eran sobre todo Llama de Meta. En 2026 el panorama es otro. Según el informe de primavera de Hugging Face, entre febrero de 2025 y febrero de 2026 los modelos abiertos chinos acumularon el 41% de todas las descargas de la plataforma. Los estadounidenses, el 36,5%.
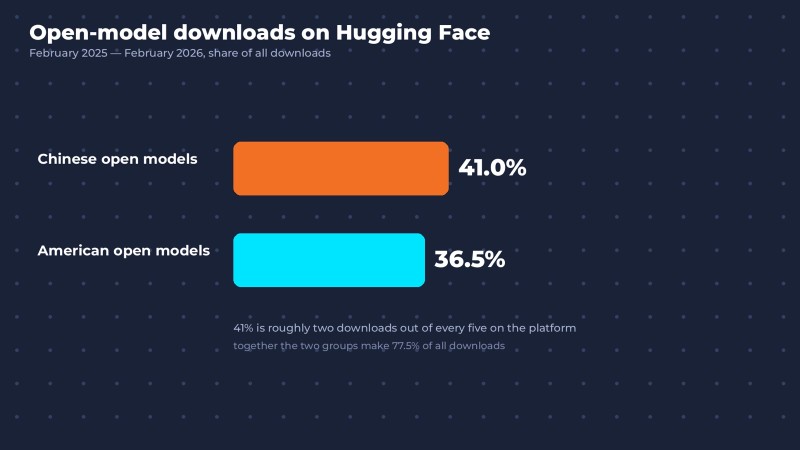
La familia Qwen de Alibaba, según distintas estimaciones, superó los mil millones de descargas y dejó atrás a Llama. Sobre ella se han ajustado más modelos derivados que sobre cualquier otra familia.
¿Por qué las empresas chinas regalan lo que OpenAI y Anthropic cobran? Hay varias razones:
- Es una estrategia para conquistar el mercado. Cuando desarrolladores de todo el mundo crean productos sobre tu modelo, te conviertes en el estándar. El dinero llega después: de la nube, de clientes corporativos y de los siguientes modelos.
- Competencia dentro de China. DeepSeek, Alibaba, Moonshot, Zhipu, MiniMax y ByteDance compiten con tanta dureza que casi cada semana alguien lanza una versión nueva.
- Entrenar es más barato. Los laboratorios chinos aprendieron a entrenar modelos potentes por menos, incluso con restricciones al suministro de chips estadounidenses.
Para el desarrollador la conclusión es simple: en 2026 hay más modelos para elegir que nunca, y parte de esa oferta es gratis.
Los principales modelos de IA chinos de 2026
Una advertencia importante desde el principio. Aquí las versiones cambian tan rápido que cualquier reseña se queda vieja en un par de meses. Lo que sigue es el estado a finales de octubre de 2026.
DeepSeek V4: la API más barata
La misma empresa que en enero de 2025 hundió las acciones de Nvidia. Ahora DeepSeek tiene dos modelos principales: V4 Pro y V4.1 Flash. La última versión de Flash salió el 17 de octubre de 2026, con pesos abiertos bajo licencia MIT y un contexto de hasta un millón de tokens.
Punto fuerte: el precio. Flash cuesta decenas de veces menos que los buques insignia occidentales y, fuera de las horas punta, aproximadamente la mitad todavía. Para automatización en segundo plano, procesamiento de documentos y tareas masivas, es casi gratis.

Punto débil: la fiabilidad en tareas agénticas complejas. Tom's Hardware, al analizar el nuevo modelo, señaló expresamente que gasta poca memoria, pero alucina más a menudo que sus competidores propietarios en escenarios agénticos.
Qwen 3.8: el modelo abierto más popular
Una familia de modelos de Alibaba. La generación actual es Qwen 3.8, y Qwen 4, según Alibaba, está en entrenamiento. La gran ventaja de Qwen es la variedad de tamaños: desde modelos compactos que de verdad puedes ejecutar en tu ordenador hasta buques insignia pesados. Las versiones pequeñas salen bajo licencia Apache 2.0, una de las más libres.
Si necesitas un modelo abierto para ajustarlo a tu propia tarea, Qwen es el primer candidato. Justo por eso es la base de más modelos derivados que ningún otro.
Kimi K3: un buque insignia para código y agentes
Un modelo de Moonshot AI. K3 salió el 16 de julio de 2026, y dos semanas después Moonshot publicó sus pesos. El tamaño impresiona: 2,8 billones de parámetros y un contexto de un millón de tokens. El modelo está pensado para tareas agénticas largas: moverse por repositorios grandes, depurar, trabajar con herramientas y logs.
Kimi ya ha salido en las noticias: hace poco encontró una vulnerabilidad RCE en Redis en 27 minutos.
El matiz: la licencia. No es MIT, sino propia: los proveedores que ganan más de 20 millones de dólares al año con la inferencia de K3 deben compartir ingresos. A ti como desarrollador difícilmente te afectará, pero conviene leer siempre la licencia antes de usar un modelo en un producto.
GLM-5: un modelo abierto para programar
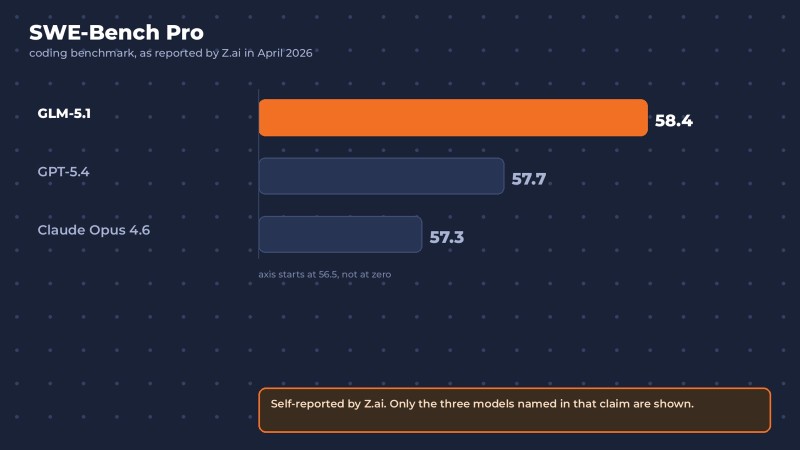
Una línea de modelos de Z.ai, antes Zhipu AI. En abril de 2026 la empresa abrió los pesos de GLM-5.1 bajo licencia MIT y, según las mediciones de la propia Z.ai, el modelo quedó primero en el benchmark SWE-Bench Pro, por delante de GPT-5.4 y Claude Opus 4.6. Advertencia: el resultado lo declara la propia empresa, y desde entonces Z.ai ha lanzado varias versiones más: aquí las novedades llegan casi cada mes.
Para desarrolladores, Z.ai ofrece un GLM Coding Plan aparte: una suscripción desde 18 $ al mes que funciona directamente dentro de Claude Code. Más sobre eso abajo.
MiniMax M3: un millón de tokens y multimodalidad
Un modelo de MiniMax lanzado en verano de 2026 con pesos abiertos. La empresa apuesta por combinar tres cosas en un solo modelo: programación potente, un contexto de un millón de tokens y trabajo nativo con imágenes. Una buena opción cuando necesitas pasarle al modelo de una vez una gran cantidad de documentación o de código.
Seedream y Seedance: imágenes y vídeo de ByteDance
Las empresas chinas no solo destacan en modelos de texto. ByteDance, la creadora de TikTok, desarrolla generadores de imágenes y vídeo que compiten con los mejores occidentales.
Seedream 5.0 es un generador de imágenes. ByteDance lo lanzó en febrero de 2026 como alternativa más barata a Nano Banana Pro de Google y en verano añadió una versión Pro. El modelo genera imágenes en 2K y 4K, edita imágenes a partir de referencias y, en su versión Lite, incluso busca información en internet antes de generar. A través de OpenRouter, una imagen de Seedream 5.0 Pro cuesta unos 0,045 $.
Seedance 2.0 es un generador de vídeo. Desde la primavera de 2026 está integrado directamente en CapCut y Dreamina, y en Dreamina ya existe la versión 2.5, que genera clips de hasta 30 segundos. Para desarrolladores hay una API a través de BytePlus.
¿Por qué le interesa esto a un desarrollador? Porque un producto no es solo código. Iconos, ilustraciones para la landing, assets para un juego, un vídeo demo para el lanzamiento: antes para todo eso hacía falta un diseñador, un editor de vídeo y presupuesto. Hoy puedes montar una primera versión en una tarde. Una sola persona con código y herramientas así saca lo que antes requería un equipo pequeño.
Comparativa: qué modelo elegir
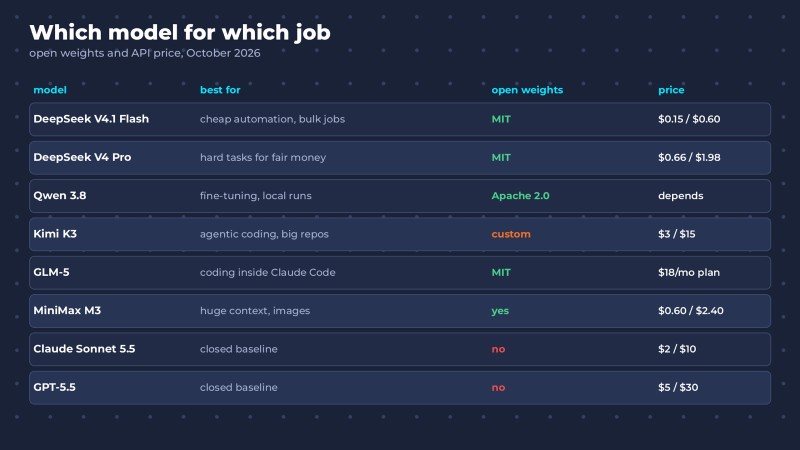
| Modelo | Ideal para | Pesos abiertos | Precio de la API (por 1 M de tokens, entrada / salida) |
| DeepSeek V4.1 Flash | Automatización barata, tareas masivas | Sí, MIT | desde 0,15 $ / 0,60 $ |
| DeepSeek V4 Pro | Tareas difíciles por un precio moderado | Sí, MIT | unos 0,66 $ / 1,98 $ |
| Qwen 3.8 | Ajuste fino, ejecución local, variedad de tamaños | Sí, versiones pequeñas con Apache 2.0 | depende del tamaño y del proveedor |
| Kimi K3 | Programación agéntica, repositorios grandes | Sí, licencia propia | 3 $ / 15 $ |
| GLM-5 | Programación, trabajo en Claude Code | Sí, MIT | Coding Plan desde 18 $/mes |
| MiniMax M3 | Contexto enorme, imágenes + código | Sí | unos 0,60 $ / 2,40 $ |
| Para comparar: Claude Sonnet 5.5 | — | No | 2 $ / 10 $ |
| Para comparar: GPT-5.5 | — | No | 5 $ / 30 $ |
Los proveedores chinos cambian precios a menudo, hay descuentos de lanzamiento y tarifas distintas en horas punta y fuera de ellas. Antes de calcular costes para un producto, consulta la página oficial de precios.
Cómo usar un modelo chino en Claude Code
Ahora la parte más práctica. Claude Code no solo funciona con modelos Claude. Envía las peticiones a la dirección de la variable de entorno ANTHROPIC_BASE_URL, y DeepSeek, Moonshot y Z.ai han creado APIs compatibles con el formato de Anthropic.
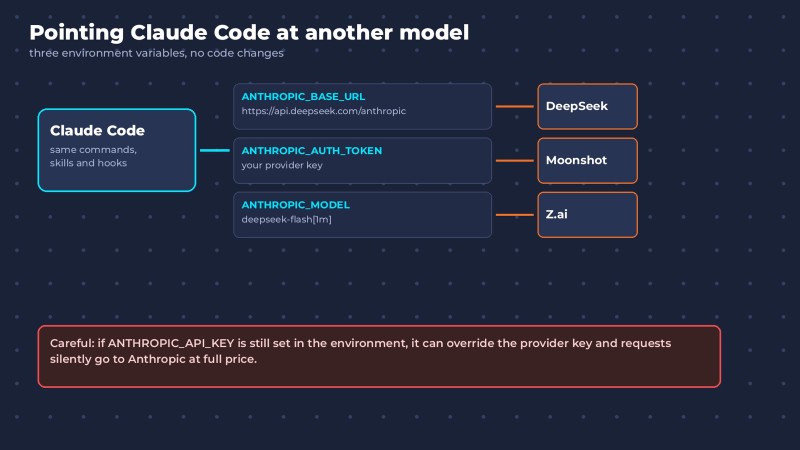
Esta es la configuración oficial de la documentación de DeepSeek:
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=<tu clave de API de DeepSeek>
export ANTHROPIC_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
claude
El sufijo [1m] activa el contexto de un millón de tokens. Si dejas en la configuración los nombres de los modelos Claude, DeepSeek redirige las peticiones por su cuenta: Opus a V4 Pro, Sonnet y Haiku a Flash.
Después, Claude Code funciona como siempre, con los mismos comandos, las mismas skills y los mismos subagentes, pero quien piensa es DeepSeek. Moonshot para Kimi K3 y Z.ai para GLM siguen el mismo esquema: su propia dirección de API y su propia clave.
Tres cosas que conviene saber de antemano:
- No es una configuración con soporte oficial de Anthropic. La documentan los propios proveedores chinos. Algunas cosas pueden funcionar distinto: por ejemplo, los modelos chinos no aparecen en el menú
/model, y puedes comprobar qué modelo está respondiendo con/status. - Vigila la variable
ANTHROPIC_API_KEY. Si sigue definida en tu entorno, puede sobrescribir la clave del proveedor, y tus peticiones irán en silencio a Anthropic a precio completo. - La calidad será distinta. Claude Code está ajustado para los modelos Claude. En tareas sencillas la diferencia apenas se nota; en sesiones agénticas largas, sí.
Cómo funcionan el propio agente, las skills, los subagentes y los hooks lo explicamos en detalle en Cómo funciona un agente de IA.
Dónde está la trampa
Las reseñas entusiastas suelen terminar aquí. Nosotros no. Estas son cuatro cosas que conviene entender antes de pasar tu trabajo a un modelo chino.
1. «Ejecútalo tú mismo» no significa en tu portátil
A las reseñas les encanta decir que los modelos chinos se pueden ejecutar con Ollama o LM Studio en tu propio ordenador. Técnicamente, sí. En la práctica, solo las versiones pequeñas. El buque insignia GLM-5.1 tiene unos 744.000 millones de parámetros, y Kimi K3, 2,8 billones. Para ejecutar algo así no basta un portátil: hace falta un rack de servidores con varias tarjetas gráficas caras.
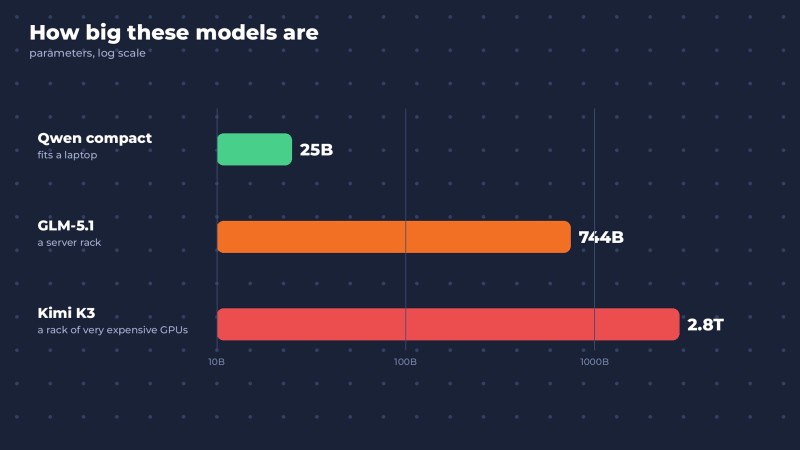
En un ordenador normal funcionan de verdad los modelos compactos destilados, por ejemplo, las versiones pequeñas de Qwen de 20.000 a 30.000 millones de parámetros. Son útiles, pero no llegan al nivel de los buques insignia.
2. Adónde van tus datos
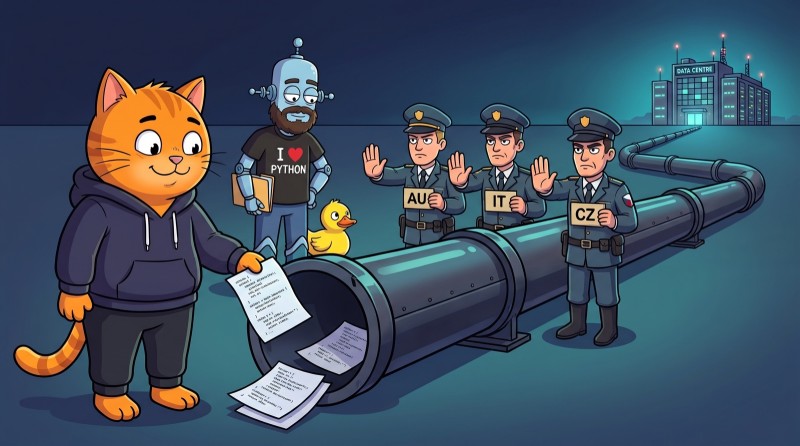
Un modelo abierto en tu propio servidor es una cosa. La API en la nube de una empresa china es otra muy distinta. La política de privacidad de DeepSeek dice claramente que las peticiones y los archivos subidos se guardan en servidores en China. Por eso Australia prohibió DeepSeek en dispositivos del Gobierno, el regulador italiano exigió retirar la app de las tiendas y la República Checa y Taiwán la prohibieron en organismos públicos.
Una regla práctica: un proyecto personal a través de una API china, adelante. El código de tu empresa, las claves y los datos de clientes, solo con ejecución local o a través de un proveedor occidental que aloje los pesos abiertos en sus servidores. Los mismos pesos, pero los datos siguen bajo tu control.
3. La basura de IA sigue existiendo
Un modelo barato no se equivoca menos que uno caro, y a veces se equivoca más. En lógica compleja y tareas agénticas largas, los modelos chinos tienden bastante más a entregar con total seguridad código que no funciona o a inventarse métodos que no existen. Los benchmarks que publican las propias empresas hay que tomarlos con pinzas: miden lo que resulta cómodo medir.
4. «Abierto» no significa «haz lo que quieras»
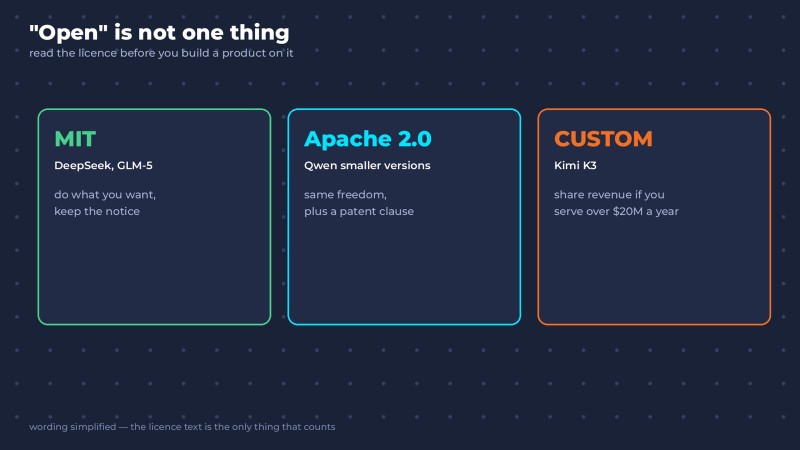
MIT y Apache 2.0 son licencias realmente libres. Pero Kimi K3 tiene una licencia propia, con condiciones para grandes proveedores comerciales. Antes de construir un producto sobre un modelo, dedica diez minutos a leer la licencia. Sale más barato que rehacer la arquitectura después.
Qué significa esto para quien desarrolla
Hay una idea antigua a la que volvemos una y otra vez: las herramientas se quedan en cero, las bases permanecen. Los modelos chinos lo demuestran mejor que nada.
Hace un año, tener acceso a un modelo potente era una ventaja. Hoy puedes conseguir un modelo de nivel insignia gratis, y dentro de un mes saldrá el siguiente, también gratis. Los modelos se están convirtiendo en materia prima, como la electricidad. Nadie presume de tener corriente en el enchufe.
El valor se desplaza hacia quien sabe usar esa corriente. Elegir un modelo según la tarea y el presupuesto. Conectarlo a un agente. Revisar lo que ha escrito y detectar dónde se equivocó con toda seguridad. Configurar los permisos para que el agente no haga un desastre. Esa es la habilidad por la que se paga. Y no pierde valor cuando sale el siguiente modelo: al contrario, gana valor.

El mejor modelo no es el que está más arriba en el benchmark, sino aquel cuyo resultado sabes verificar.
Dónde aprenderlo
Trabajar con agentes sin depender de un modelo concreto es justo de lo que trata nuestro curso Desarrollo con Claude Code de AI Academy. 16 niveles y más de 200 tareas: permisos y contexto, skills, subagentes, MCP, hooks, plan mode y control con git. Todo funciona igual, sea cual sea el modelo que haya debajo.
Y si estás empezando a programar, empieza por las bases: para verificar lo que escribe un modelo, tienes que saber leer código. Eso es justo lo que entrena nuestro curso de Python, con miles de tareas con corrección instantánea.
Preguntas frecuentes
¿Cuáles son los mejores modelos de IA chinos en 2026? A finales de octubre de 2026, los principales son DeepSeek V4 (la API más barata), Qwen 3.8 de Alibaba (el modelo abierto más popular), Kimi K3 de Moonshot AI (programación agéntica y repositorios grandes), la línea GLM-5 de Z.ai (programación, trabajo en Claude Code) y MiniMax M3 (un millón de tokens de contexto y multimodalidad). Para imágenes y vídeo, Seedream 5.0 y Seedance 2.0 de ByteDance.
¿Pueden los modelos de IA chinos sustituir a ChatGPT y Claude? Para muchas tareas, sí: automatización, procesamiento de documentos, generación de código de complejidad media. En lógica compleja y escenarios agénticos largos, los modelos chinos todavía se equivocan más a menudo. Sus principales ventajas son precios de API decenas de veces menores y la posibilidad de ejecutar el modelo en tu propio servidor.
¿Cuánto cuesta la API de los modelos de IA chinos? DeepSeek V4.1 Flash cuesta desde 0,15 $ por millón de tokens de entrada y 0,60 $ por millón de salida. Kimi K3 cuesta 3 $ y 15 $. Para comparar: Claude Sonnet 5.5 cuesta 2 $ y 10 $, y GPT-5.5, 5 $ y 30 $. Los precios cambian a menudo, así que consulta las páginas oficiales de los proveedores.
¿Puedo ejecutar un modelo de IA chino en mi ordenador? Solo las versiones compactas, por ejemplo, los modelos pequeños de Qwen de 20.000 a 30.000 millones de parámetros con Ollama o LM Studio. Los buques insignia como GLM-5.1 (unos 744.000 millones de parámetros) o Kimi K3 (2,8 billones) necesitan hardware de servidor con varias tarjetas gráficas potentes.
¿Es seguro enviar código a modelos de IA chinos? A través de una API en la nube, con precaución: DeepSeek, por ejemplo, guarda las peticiones y los archivos en servidores en China, por lo que varios países lo han prohibido en dispositivos del Gobierno. Para el código de empresa y los datos de clientes, es más seguro ejecutar los pesos abiertos en local o a través de un proveedor occidental que los aloje.
¿Cómo uso DeepSeek o Kimi con Claude Code? Con variables de entorno: define ANTHROPIC_BASE_URL con la dirección compatible con Anthropic del proveedor (por ejemplo, https://api.deepseek.com/anthropic), la clave del proveedor en ANTHROPIC_AUTH_TOKEN y el nombre del modelo en ANTHROPIC_MODEL. Es una configuración documentada por los proveedores, pero sin soporte oficial de Anthropic.
GO TO FULL VERSION