Tu te souviens de ta première conversation avec ChatGPT ? Cette sensation de parler avec quelque chose... de vivant. Tu poses une question — tu obtiens une réponse réfléchie. Tu écris quelque chose de vague — il comprend quand même ce que tu veux dire.
De la magie ? Non. Des maths.
Derrière ces quelques secondes de "réflexion" se cache un processus que tu peux décomposer pièce par pièce. Du premier caractère de ton prompt au dernier mot de la réponse — tout est logique, calculé, prévisible. Et comprendre comment fonctionne l'intelligence artificielle est plus simple que tu ne le penses — même sans bagage technique.
Cet article est ton guide sur les réseaux neuronaux pour débutants. Découvrons comment un ordinateur qui ne comprend que des zéros et des uns a appris à comprendre le langage humain.
Que font vraiment les réseaux neuronaux quand tu écris un prompt ?
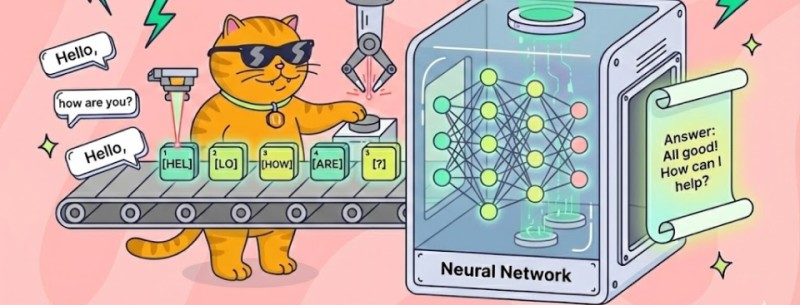
La tâche de tout modèle de langage se résume à un principe simple : prendre une séquence d'entrée (ton prompt) et la transformer en sortie (la réponse). Dans les cercles académiques, on appelle ça élégamment transduction de séquence — transformer une séquence en une autre.
Mais d'abord, clarifions ce que sont les modèles de langage. Ce sont des réseaux neuronaux entraînés sur d'énormes quantités de texte — des milliards ou des billions de mots d'Internet, de livres, de code. Ils ont appris à trouver des motifs dans le langage : comment les mots se combinent, quelles phrases ont du sens, lesquelles n'en ont pas.
Mais comment ils font — c'est toute une science.
Les premiers modèles d'IA lisaient le texte comme nous lisons un livre : mot par mot, de gauche à droite. Les réseaux neuronaux modernes ont appris à faire mieux — ils voient tout le texte d'un coup, comme si tu regardais une page et saisissais instantanément l'essentiel.
La réponse ? Le modèle la génère toujours à l'ancienne : mot par mot. Il écrit un mot, "réfléchit", écrit le suivant. Tu as remarqué comment le texte apparaît progressivement dans ChatGPT ? Ce n'est pas une animation pour l'effet. Le modèle fonctionne vraiment comme ça — il prédit chaque mot suivant à la volée.
Pourquoi pas toute la réponse d'un coup ? Parce que c'est plus simple ainsi. Tu peux surveiller le processus, ajuster à la volée, et surtout — tu n'as pas besoin de garder tout le texte en mémoire. Il calcule le mot suivant, l'ajoute, continue.
L'objectif principal de l'IA dans tout ça : préserver le sens de ton prompt et produire quelque chose de cohérent. Ça semble simple, mais derrière se cachent des décennies de recherche.
Maintenant, décortiquons comment tout fonctionne. Des premières tentatives aux systèmes modernes qui semblent magiques.
Chapitre un : Comment les réseaux neuronaux ont appris à lire le texte — Des RNN aux transformers
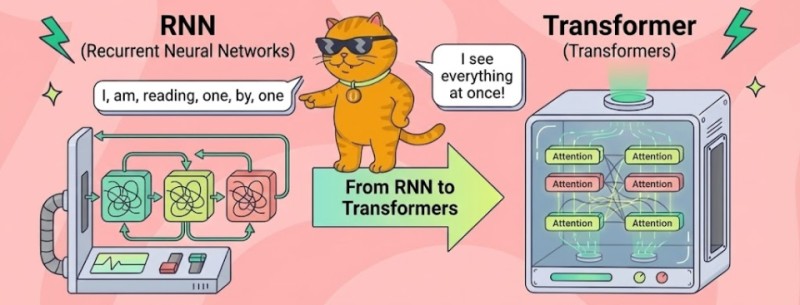
Tu te souviens avoir lu un long poème à l'école ? Tu arrivais au milieu et le début avait déjà disparu de ta mémoire. Tu devais revenir en arrière et relire. Les premiers réseaux neuronaux pour le traitement du texte fonctionnaient à peu près de la même manière.
Ils s'appellent réseaux neuronaux récurrents, ou RNN. Ça sonne comme un nom de vaisseau spatial, mais en réalité c'est juste une façon de lire le texte mot par mot. Imagine une boucle for en programmation — tu parcours le texte de gauche à droite, tu traites chaque mot, tu avances.
Voici une phrase simple : "Hier j'ai vu un chat qui était assis sur une clôture en miaulant à la lune."
RNN la lit comme ça :
- "Hier" — ok, mémorisé
- "j'ai" — ouais, noté
- "vu" — enregistré
- "un" — check
- "chat" — stocké
- "qui" — attends, "qui" fait référence à quoi ?
À ce moment-là, le réseau commence déjà à oublier ce qui était au début. La connexion entre les mots se perd. Surtout si la phrase est longue. Maintenant imagine un paragraphe entier ou un article !
Le problème des dépendances à long terme
Voici un exemple classique qui cassait tous les RNN de cette époque :
"J'ai grandi à Paris. J'y ai passé toute mon enfance. J'allais à l'école locale, je jouais avec des amis dans la cour, j'apprenais la langue. C'est pourquoi je parle couramment..."
Quelle langue je parle ? Exactement, le français. Mais pour comprendre ça, il faut se souvenir de Paris du tout début. Et à la fin de la phrase, RNN l'a complètement oublié.
C'est comme regarder un polar et oublier les indices en chemin. À la fin, tu ne sais pas qui est le meurtrier parce que tu as oublié qui était même dans le manoir ce soir-là.
LSTM — mémoire avec accès sélectif
Au milieu des années 90, ils ont trouvé une amélioration : Long Short-Term Memory. Le nom est contradictoire — "mémoire à court terme longue". Ça sonne comme un oxymore, mais ça fonctionne.
L'idée est simple : apprenons au réseau à décider ce qui est important à retenir et ce qui peut être oublié. Imagine que tu lis un manuel avec un surligneur. Tu surlignes les parties importantes, tu sautes le reste. Puis tu ne reviens qu'à ce qui est surligné.
LSTM fait la même chose. Il a un système de "portes" qui décide : ce mot est important (transférer à la mémoire à long terme) ou pas (oublier). Le modèle a appris à déterminer lui-même ce qui compte.
C'est devenu mieux. Mais pas beaucoup. Le réseau lisait toujours séquentiellement, mot par mot. Lentement. Et sur les longs textes, il faisait toujours des erreurs.
Réseaux convolutifs — lire plusieurs mots à la fois
Ensuite, ils ont essayé les réseaux de neurones convolutifs (CNN). Ce sont les mêmes réseaux qui ont appris à reconnaître les chats sur les photos. Ils ont essayé de les appliquer au texte.
L'astuce des CNN : ils ne regardent pas un mot mais un groupe à la fois. Un peu comme tu lis non pas lettre par lettre, mais des mots entiers. Ou même des phrases, si tu as une bonne capacité de lecture.
Les CNN lisaient le texte par "fenêtres" : trois mots ensemble, puis les trois suivants, puis les suivants. À la couche suivante, ces triplets fusionnaient en groupes de neuf mots. Et ainsi de suite, jusqu'à ce qu'ils capturent toute la phrase.
Mais les inconvénients l'emportaient toujours sur les avantages. Ils travaillaient lentement. Coincés sur les longs textes. Et surtout — ils ne voyaient toujours pas toute l'image d'un coup.
Une révolution était nécessaire.
Chapitre deux : Mécanisme d'attention et transformers — comment fonctionne l'IA moderne
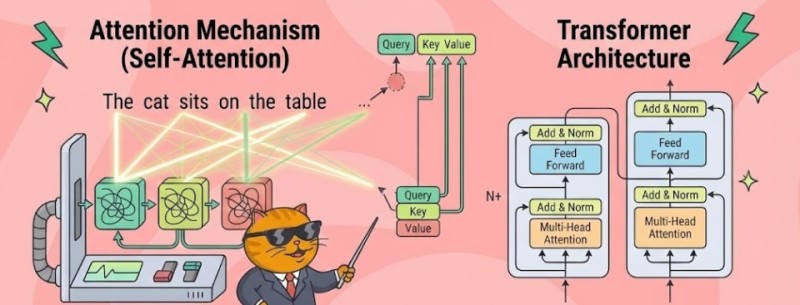
En 2017, un article est sorti avec un titre simple : "Attention Is All You Need". Ça sonnait audacieux. Mais ils avaient raison.
C'était la percée. Imagine qu'au lieu de lire le texte mot par mot, tu puisses voir TOUS les mots d'un coup. Et pas seulement les voir, mais comprendre instantanément comment chaque mot se rapporte à chaque autre.

Tout a changé.
Tokens — le langage des réseaux neuronaux
D'abord, comprenons ce qu'est un token. Ce n'est pas un mot. Et pas une lettre. Quelque chose entre les deux.
Quand tu écris un prompt à ChatGPT, il ne voit pas tes mots. Il voit des tokens. Le modèle découpe le texte en morceaux et les transforme en nombres. Les ordinateurs ne savent travailler qu'avec des nombres.
Voici un exemple simple :
"Bonjour, monde !"
Pour le modèle, c'est à peu près comme ça :
[Bonjour] [,] [monde] [!]
Quatre tokens. Pas trois mots, pas quinze caractères. Quatre tokens.
Mais voici où ça devient intéressant. Différentes langues utilisent différents nombres de tokens pour la même signification. L'anglais est en fait l'une des langues les plus "efficaces" pour la tokenisation. Dans les langues à morphologie complexe — comme l'allemand, le polonais, l'arabe ou le chinois — la même phrase nécessite souvent 2 à 4 fois plus de tokens.
Pourquoi ? Parce que l'anglais a une grammaire relativement simple et des mots plus courts. Les langues avec beaucoup de cas, de genres ou de systèmes d'écriture basés sur des caractères ont besoin de plus de tokens pour exprimer la même chose.
Exemple : "Hello, how are you?" en anglais = ~5 tokens. La même phrase en allemand ("Hallo, wie geht es dir?") = ~8-9 tokens. En chinois = ~7-8 tokens.
Tu as une limite de 100 000 tokens ? En anglais, c'est des kilomètres de texte. Dans beaucoup d'autres langues — 2 à 3 fois moins.
Astuce de pro : Si tu as une limite stricte de tokens et que tu travailles dans une langue non anglaise, envisage de traduire ton prompt en anglais d'abord. Tu économiseras considérablement sur l'utilisation des tokens.
Vecteurs — comment les nombres obtiennent du sens
Ok, le texte s'est transformé en tokens. Les tokens en nombres. Mais comment les nombres peuvent-ils transmettre du sens ?
C'est là que la beauté des mathématiques commence.
Chaque token se voit attribuer non pas un nombre, mais tout un ensemble de nombres. Un vecteur. Imagine des coordonnées dans un espace multidimensionnel. Pas en deux ou trois dimensions, mais en centaines ou milliers.
Le mot "chat" — c'est un vecteur de 768 nombres.
Le mot "chaton" — aussi un vecteur de 768 nombres.
Et tu sais quoi ? Ces vecteurs seront proches l'un de l'autre. Parce que les mots sont proches en signification.
Et le mot "asphalte" sera loin d'eux.
Voici un exemple plus simple. Prends la phrase : "Le soir à la maison regarder un film."
Dans l'esprit du modèle, ça ressemble à peu près à ça (simplifié) :
- soir : [0.8, 0.3, 0.1, 0.9]
- maison : [0.7, 0.4, 0.2, 0.8]
- regarder : [0.2, 0.9, 0.8, 0.3]
- film : [0.3, 0.9, 0.7, 0.2]
Tu vois ? "Soir" et "maison" sont proches (tous deux concernent le cadre). "Regarder" et "film" sont aussi proches (action et objet).
Le modèle voit cette proximité et comprend les connexions dans le texte.
Mécanisme d'attention — la percée principale
Maintenant la partie la plus importante. Mécanisme d'attention.
Imagine que tu lis un roman policier. Au début, ils mentionnent que le majordome était dans le jardin. Au milieu, ils parlent de thé empoisonné. À la fin, ils trouvent le propriétaire mort.
Ton cerveau connecte automatiquement ces trois faits. Majordome → jardin → thé → mort. Hmm, suspect.
Le mécanisme d'attention fait la même chose. Il regarde chaque mot et demande : "Avec quels autres mots du texte celui-ci est-il connecté ?"
Prends la phrase : "La rive du fleuve était escarpée."
Le mot "rive" pourrait signifier :
- Une institution financière (banque)
- Le bord d'une rivière (rive)
Le mécanisme d'attention regarde le mot "fleuve" et comprend : ok, ici "rive" signifie le bord. Il a connecté deux mots, éliminé l'ambiguïté.
Maintenant la phrase : "La banque a augmenté les taux d'intérêt."
Ici "banque" est connecté avec "taux d'intérêt". Donc c'est une institution financière.
Le modèle vérifie toutes les connexions simultanément. Pas séquentiellement. En parallèle.
C'est la différence clé avec RNN.
Self-attention — quand le texte se regarde lui-même
Il y a un type spécial d'attention : self-attention.
Le modèle prend un token et vérifie sa connexion avec tous les autres tokens du texte. Puis prend le token suivant — et encore avec tous. Et ainsi de suite en boucle.
Imagine une matrice de connexions. Chaque mot est vérifié contre chaque. Tu obtiens une carte des interactions.
Prends la phrase : "Le chat a poursuivi la souris, mais elle s'est échappée."
Self-attention trouve :
- "elle" est connecté à "souris" (pas à "chat")
- "poursuivi" est connecté à "chat" (c'est le chat qui a poursuivi)
- "échappée" est connecté à "souris" (c'est la souris qui s'est échappée)
Tout automatiquement. Pas de règles de grammaire. Le modèle a vu les motifs dans les données lui-même.
Multi-head attention — plusieurs vues à la fois
Mais ce n'est pas tout. Il s'est avéré qu'un seul mécanisme d'attention ne suffit pas.
Ils ont inventé multi-head attention — attention multiple.
L'essence : exécuter plusieurs mécanismes d'attention en parallèle. Chacun regarde le texte sous son propre angle.
Une "tête" cherche les connexions grammaticales.
Une autre — sémantiques (basées sur le sens).
Une troisième — syntaxiques.
Puis tous les résultats sont combinés.
C'est comme regarder un tableau sous différents angles. Chaque vue donne un nouvel aperçu. Ensemble tu obtiens l'image complète.
GPT-3 utilise 96 têtes d'attention. Claude 3.5 — encore plus. Chaque tête cherche ses propres motifs.
Encodage positionnel — comment le modèle se souvient de l'ordre des mots
Il y a un problème avec le traitement parallèle : le modèle perd la compréhension de l'ordre des mots.
"Le chat a mangé la souris" et "La souris a mangé le chat" — différents en signification, mais si tu enlèves l'ordre, pour le modèle ils sont identiques.
Solution : encodage positionnel.
Un nombre spécial est ajouté à chaque token qui dit : "Tu es le premier", "Tu es le deuxième", "Tu es le dixième".
Ces nombres sont encodés d'une manière spéciale (par sinusoïdes) pour que le modèle comprenne non seulement la position absolue ("tu es le troisième"), mais aussi relative ("tu es à deux mots du début").
Maintenant le modèle sait : "chat" vient avant "mangé", et "souris" — après. Ordre restauré.
Chapitre trois : Architecture du transformer — les couches qui construisent la compréhension
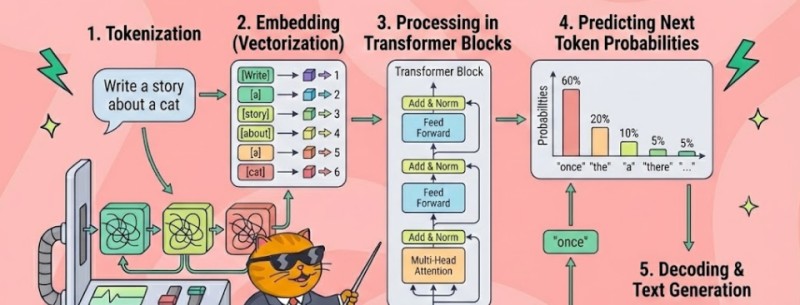
Un transformer n'est pas un seul réseau neuronal. C'est une pile de nombreuses couches, chacune faisant son propre travail.
Imagine une chaîne de montage dans une usine. La matière première entre d'un côté, passe par des dizaines de stations, sort comme produit fini.
Pareil avec le texte.
Encodeur — lit le texte
La première partie du transformer est l'encodeur. Sa tâche : lire le texte d'entrée et le comprendre.
L'encodeur se compose de plusieurs couches. Structure typique :
- Couche self-attention (on regarde les connexions entre les mots)
- Couche feed-forward (on traite chaque mot indépendamment)
- Normalisation (on stabilise les nombres)
- Connexions résiduelles (on préserve l'information des couches précédentes)
Chaque couche ajoute un nouveau niveau de compréhension.
La première couche voit des connexions simples : nom connecté à adjectif.
La deuxième couche voit des phrases : "voiture rouge".
La troisième couche voit des phrases : "La voiture rouge s'est arrêtée".
La quatrième couche voit des paragraphes : la logique du texte, les transitions entre les pensées.
GPT-3 a 96 de ces couches. Chacune creuse plus profond.
Décodeur — écrit la réponse
La deuxième partie est le décodeur. Sa tâche : générer du texte.
Le décodeur est similaire à l'encodeur, mais avec une différence : il fonctionne séquentiellement. Il écrit un token, l'ajoute au contexte, écrit le suivant.
Structure de la couche du décodeur :
- Masked self-attention (on ne regarde que les tokens déjà écrits)
- Cross-attention (on se connecte avec la sortie de l'encodeur)
- Couche feed-forward
- Normalisation et connexions résiduelles
Masked attention est un détail important. Le décodeur ne voit pas le futur. Quand il écrit le cinquième mot, il ne sait pas ce que sera le sixième.
Ce n'est pas un bug, c'est une fonctionnalité. Ainsi le modèle apprend à prédire le token suivant basé uniquement sur les précédents.
Entraînement du transformer — comment l'IA apprend à écrire
Le processus d'entraînement est simple en essence mais complexe en mise en œuvre.
Le modèle reçoit un texte énorme. Des billions de mots. Tout Internet, en gros.
Tâche : prédire le mot suivant.
Le modèle voit : "Le chat était assis sur..."
Essaie de deviner : "clôture".
Vérifie la réponse dans le texte.
Faux ? Ajuste ses poids.
Répète des millions de fois.
Progressivement le modèle apprend :
- La grammaire (après "sur" vient généralement un nom)
- Le sens (un chat peut s'asseoir sur une clôture, mais pas sur un nuage)
- Le style (le texte formel diffère du conversationnel)
- Les faits (la capitale de la France est Paris)
Tout ça — à partir des statistiques. Le modèle voit : dans 90% des cas après "capitale de la France" vient le mot "Paris". Donc c'est la bonne réponse.
L'entraînement de GPT-3 a coûté 4,6 millions de dollars en électricité. GPT-4 — des dizaines de millions. C'est des semaines de travail de supercalculateurs.
Fine-tuning — rendre le modèle utile
Après l'entraînement de base, le modèle peut prédire les mots mais ne sait pas comment être un assistant.
Besoin de fine-tuning — entraînement supplémentaire.
On montre au modèle des exemples de dialogues :
- Bonnes réponses (utiles, polies, précises)
- Mauvaises réponses (impolies, fausses, dangereuses)
Le modèle apprend à distinguer : qu'est-ce qui est bon, qu'est-ce qui est mauvais.
La méthode utilisée est RLHF (Reinforcement Learning from Human Feedback) — apprentissage par renforcement basé sur les évaluations humaines.
Processus :
- Le modèle génère plusieurs réponses à une question
- Les gens évaluent : quelle réponse est meilleure
- Le modèle apprend à générer des réponses similaires à celles que les gens ont bien notées
C'est ainsi que ChatGPT est devenu poli et utile. Le modèle GPT de base continuerait juste le texte, ne répondrait pas aux questions.
Chapitre quatre : Prompt engineering — comment parler correctement à l'IA
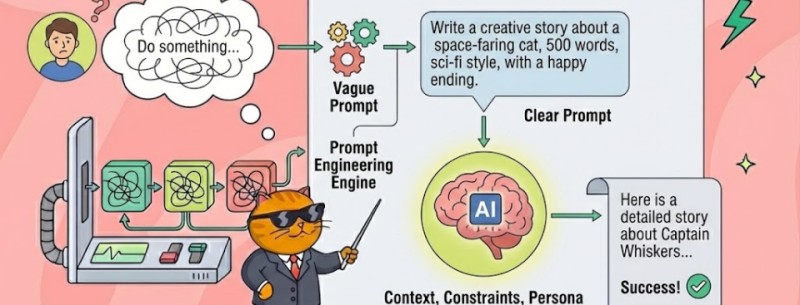
Tu comprends maintenant comment fonctionne le modèle. Maintenant apprenons à interagir correctement avec lui.
Un prompt n'est pas juste une demande. C'est une instruction pour l'IA. Et la qualité de la réponse dépend de comment tu l'écris.
Principes de base d'un bon prompt
1. Sois spécifique
Mauvais : "Écris un article"
Bon : "Écris un article de 1000 mots sur le prompt engineering pour les programmeurs débutants, style conversationnel, avec des exemples pratiques"
2. Fournis du contexte
Mauvais : "Explique la récursion"
Bon : "Je suis débutant en Python. Explique la récursion en termes simples, avec un exemple de code et une analogie de la vie réelle"
3. Donne des exemples
Mauvais : "Traduis en anglais"
Bon : "Traduis en anglais dans un style informel. Exemple : 'Salut, ça va ?' → 'Hey, what's up?'"
4. Structure ta demande
Mauvais : long désordre d'exigences
Bon : liste numérotée de tâches
Few-shot prompting — enseigner avec des exemples
L'une des techniques les plus puissantes : donne au modèle des exemples de ce que tu veux.
Tâche : classifier le sentiment des avis.
Avis : "Excellent produit, livraison rapide !"
Sentiment : Positif

Avis : "Emballage endommagé, produit cassé à l'arrivée"
Sentiment : Négatif

Avis : "Produit moyen, rien de spécial"
Sentiment : Neutre

Avis : "A dépassé toutes les attentes, je vais commander à nouveau !"
Sentiment :
Le modèle voit le motif et continue : "Positif".
Ça fonctionne pour les traductions, le formatage, l'analyse — tout.
Chain-of-thought — enseigner à penser étape par étape
Parfois la tâche est complexe. Le modèle fait des erreurs s'il essaie de répondre immédiatement.
Solution : demande-lui de penser étape par étape.
Mauvais prompt : "Résous le problème : Si les pommes au magasin coûtent 2€ le kilo, j'ai acheté 3,5 kilos et donné 20€ à la caissière. Combien de monnaie vais-je recevoir ?"
Le modèle pourrait faire des erreurs arithmétiques.
Bon prompt : "Résous le problème étape par étape :
1. Calcule le coût d'achat
2. Soustrais du montant donné
3. Donne la réponse finale
Problème : Si les pommes au magasin coûtent 2€ le kilo, j'ai acheté 3,5 kilos et donné 20€ à la caissière. Combien de monnaie vais-je recevoir ?"
Le modèle pense :
- Étape 1 : 2 × 3,5 = 7€
- Étape 2 : 20 - 7 = 13€
- Étape 3 : Tu recevras 13€ de monnaie
La précision augmente considérablement.
Role prompting — assigner un rôle au modèle
Tu veux une réponse d'expert ? Dis au modèle qui il est.
"Tu es un développeur Python expérimenté avec 10 ans d'expérience. Explique pourquoi les list comprehensions en Python sont plus efficaces que les boucles for."
Le modèle endossera le rôle et répondra comme un expert.
"Tu es un prof de maths pour la 5ème. Explique le théorème de Pythagore en termes simples."
La réponse sera adaptée au public.
Negative prompting — dire ce qu'il NE faut PAS faire
Parfois c'est plus facile de dire ce que tu ne veux PAS.
"Écris une brève description de produit. N'utilise pas les mots 'innovant', 'révolutionnaire', 'unique'. Pas de blabla marketing, juste des faits."
Le modèle tiendra compte des limitations.
Chapitre cinq : Comment les modèles peuvent se tromper — hallucinations et limites
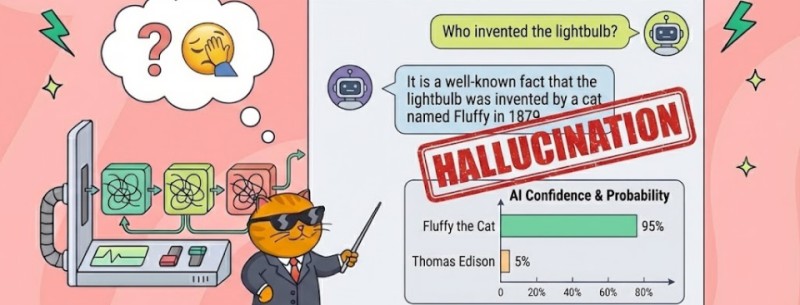
L'IA n'est pas parfaite. Il est important de comprendre ses limitations.
Hallucinations — quand le modèle ment avec confiance
Le problème le plus connu avec les modèles de langage : ils inventent parfois des faits.
Tu demandes : "Qui a inventé l'ordinateur quantique ?"
Le modèle répond avec confiance : "L'ordinateur quantique a été inventé par David Deutsch en 1985."
Ça sonne convaincant. Mais c'est un mensonge. Deutsch est un vrai scientifique, mais la date et la formulation sont inexactes.
Pourquoi ça arrive ?
Le modèle ne "connaît" pas les faits au sens habituel. Il prédit des mots probables. Si David Deutsch était souvent mentionné près des ordinateurs quantiques dans les données d'entraînement, le modèle les connectera.
Mais les détails peuvent être faux.
Comment te protéger :
- Vérifie les faits dans des sources fiables
- Demande au modèle de citer ses sources
- Utilise des commandes comme "Si pas sûr, dis 'Je ne sais pas'"
Fenêtre contextuelle — limite de mémoire
Le modèle ne peut pas se souvenir éternellement. Il a une limite.
GPT-4 : 128 000 tokens (environ 300 pages de texte)
Claude 3.5 : 200 000 tokens
Gemini 1.5 Pro : 1 million de tokens
Si le dialogue devient plus long, le modèle commence à "oublier" le début.
Les premiers messages sortent du contexte. Le modèle ne les voit plus.
Solution : résume périodiquement le dialogue et commence une nouvelle session avec un bref résumé de la précédente.
Biais et toxicité
Les modèles sont entraînés sur des données d'Internet. Et Internet... eh bien, il n'est pas parfait.
Les données d'entraînement incluent :
- Stéréotypes de genre
- Préjugés raciaux
- Expressions toxiques
- Engagement politique
Le modèle peut absorber ces schémas.
Les développeurs luttent contre ça par :
- Filtrage des données
- RLHF pour éliminer la toxicité
- Limitations spéciales dans les prompts
Mais le problème n'est pas complètement résolu.
Coûts de calcul
Exécuter GPT-4 sur une demande coûte environ 0,03$. Ça semble peu ?
Si tu as un million d'utilisateurs, chacun faisant 10 demandes par jour — c'est 300 000$ par jour. 9 millions de dollars par mois.
C'est pourquoi de nombreux services limitent le nombre de demandes ou facturent un abonnement.
La puissance de calcul est un goulot d'étranglement. Tant que les modèles ne deviennent pas plus légers, les coûts resteront élevés.
Chapitre six : Évolution des modèles — De GPT-3 aux systèmes modernes
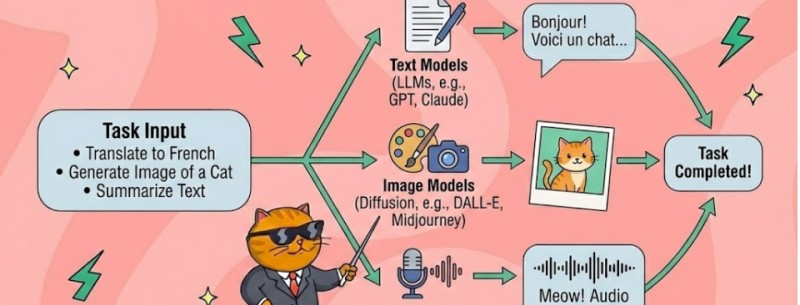
Dans les trois ans depuis la sortie de GPT-3 (2020), il y a eu une révolution.
GPT-4 — un pas vers la multimodalité
GPT-4 ne lit pas seulement le texte. Il voit les images.
Télécharge une photo d'une interface, demande-lui d'écrire du code — tu obtiens du HTML/CSS fonctionnel.
Montre un dessin, demande une explication — tu obtiens une description détaillée.
C'est le premier pas vers des modèles qui comprennent le monde comme nous : par une combinaison de mots et d'images.
Claude d'Anthropic — focus sur la sécurité
Claude a été créé par une entreprise fondée par d'anciens employés d'OpenAI. Leur focus : sécurité et honnêteté.
Claude hallucine moins souvent. Il admet quand il n'est pas sûr. Refuse les demandes toxiques plus systématiquement.
Et Claude a une énorme fenêtre contextuelle. 200 000 tokens. Tu peux télécharger un livre entier et travailler avec.
Gemini de Google — vitesse et multitâche
Gemini 1.5 Pro peut traiter 1 million de tokens. C'est environ 1 500 pages de texte.
Télécharge toute une base de code de projet, demande de trouver des bugs — il les trouve.
Donne-lui plusieurs heures de vidéo, demande un résumé — il résume.
Google mise sur la vitesse et le volume.
Modèles multimodaux — tout en un
GPT-4o :
- Voit les images
- Entend l'audio
- Lit le texte
- Répond avec texte, voix ou image
Un modèle comprend tout. C'est le futur.
Tu peux télécharger une photo, demander par la voix "Qu'est-ce que c'est ?" — et obtenir aussi une réponse par la voix.
Chapitre sept : Le futur est déjà là (mais inégalement distribué)
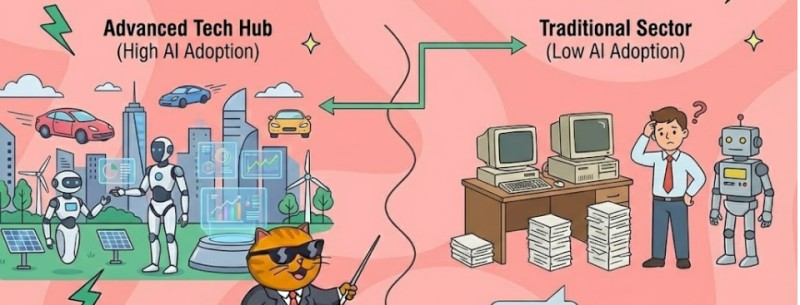
Février 2025. GitHub annonce Agent Mode pour Copilot.
Maintenant l'IA ne complète pas juste le code. Elle exécute les tâches elle-même.
Tu fixes une tâche : "Ajoute l'authentification OAuth au projet." Elle :
- Analyse le code actuel
- Trouve les bibliothèques nécessaires
- Écrit le code
- Teste
- Crée une pull request
Tu vérifies juste le résultat.
Mai 2025. Annonce de Coding Agent — une version encore plus autonome. Elle travaille dans un environnement de développement cloud, fait elle-même les commits, pousse elle-même les changements.
Ce n'est pas de la science-fiction. Ça fonctionne déjà.
Modèles spécialisés
Les modèles universels sont bons, mais les spécialisés sont meilleurs dans leurs tâches.
Med-PaLM (Google) :
Entraîné sur des données médicales
Conseille les médecins
Plus précis que GPT sur les questions médicales
LawGPT :
Consultations juridiques
Analyse de contrats
Recherche de précédents
BioGPT :
Biologie, chimie, pharmacologie
Prédiction de structure protéique
Développement de nouveaux médicaments
Ces modèles sont affinés sur des ensembles de données spécialisés. Leur tokenisation est aussi adaptée : les termes juridiques et les abréviations médicales sont des tokens séparés.
Questions éthiques
Tout ça est cool, mais il y a des problèmes.
Droits d'auteur :
Les modèles sont entraînés sur des données publiques. Mais beaucoup sont protégées par des droits d'auteur. Des procédures judiciaires sont en cours. GitHub Copilot a déjà fait face à un procès pour générer du code similaire à celui d'autres.
Hallucinations dans les domaines critiques :
Un médecin IA peut faire des erreurs. Un avocat IA aussi. Les conséquences sont graves.
Vulnérabilités du code :
Rappelle-toi : 40% du code de Copilot peut être non sécurisé. Les développeurs doivent vérifier.
Remplacement d'emplois :
Rédacteurs, artistes, programmeurs — tous ressentent la pression. Mais de nouvelles professions émergent : prompt engineers, formateurs IA, spécialistes de l'éthique IA.
Et ensuite ?
Les modèles deviendront plus intelligents.
GPT-5 est déjà en développement. Comprendra encore mieux, fera moins d'erreurs.

Le contexte deviendra plus grand.
Des millions de tokens de contexte — c'est une question de quelques années. Tu pourras télécharger toute une bibliothèque de documentation et travailler avec.
Les agents deviendront la norme.
L'IA ne fera pas que répondre. Elle agira. Réserver des billets, écrire du code, créer du contenu. De façon autonome.
La personnalisation s'intensifiera.
Ton assistant IA personnel qui connaît tes préférences, ton style de travail, tes objectifs. Ne travaille que pour toi.
Mais une chose ne changera pas : l'IA reste un outil. Puissant, mais nécessitant une compréhension.
Questions fréquemment posées sur le fonctionnement des réseaux neuronaux
Qu'est-ce qu'un token dans les réseaux neuronaux ?
Un token est l'unité minimale de texte avec laquelle un modèle de langage travaille. Pas un mot entier et pas une seule lettre, mais un fragment. En anglais, un token équivaut en moyenne à quatre caractères ; en russe — à un caractère. Le modèle découpe tout le texte en tokens, les transforme en nombres, et seulement après commence le traitement.
Pourquoi ChatGPT donne-t-il parfois de mauvaises réponses ?
Les modèles de langage ne "connaissent" pas l'information au sens habituel. Ils prédisent le token suivant basé sur des schémas statistiques qu'ils ont vus dans les données d'entraînement. Le modèle peut créer une réponse plausible mais fausse — c'est ce qu'on appelle une hallucination. Cela arrive surtout avec des faits rares, des dates après l'entraînement du modèle, ou des questions très spécifiques.
Qu'est-ce que le mécanisme d'attention ?
Le mécanisme d'attention permet au modèle de voir les connexions entre tous les mots du texte simultanément, plutôt que de les traiter séquentiellement. Quand tu écris "La rive du fleuve était escarpée", le modèle voit le mot "fleuve" et comprend que "rive" ici est un bord, pas une institution financière. Il vérifie les connexions entre tous les tokens en parallèle.
En quoi un transformer diffère-t-il d'un réseau neuronal normal ?
Un transformer utilise un mécanisme d'attention pour le traitement parallèle du texte. Les anciennes architectures (RNN, LSTM) lisaient le texte séquentiellement, comme une personne lit un livre — mot par mot. Un transformer voit tout le texte d'un coup, comme regarder une page entière. C'est plus rapide et plus précis.
Comment écrire un bon prompt pour l'IA ?
Un bon prompt doit être spécifique : indiquer le public cible, le style, le volume, la structure de réponse. Mauvais : "Écris un article." Bon : "Écris un article de 1000 mots sur le prompt engineering pour les programmeurs débutants, style conversationnel, avec des exemples pratiques." Utilise des techniques comme le few-shot prompting (donner des exemples) ou le chain-of-thought (demander de penser étape par étape).
Pourquoi certaines langues sont-elles "plus chères" pour les réseaux neuronaux ?
Parce que l'efficacité de la tokenisation varie selon la langue. Les langues à morphologie complexe (beaucoup de terminaisons, préfixes, suffixes) ou les systèmes d'écriture basés sur des caractères nécessitent plus de tokens pour exprimer le même sens. L'anglais est relativement efficace — un token équivaut en moyenne à environ quatre caractères. En allemand, polonais, arabe ou chinois, les tokeniseurs ont souvent besoin de 2 à 4 fois plus de tokens pour un contenu équivalent. Résultat : le même texte coûte beaucoup plus de tokens dans les langues morphologiquement complexes qu'en anglais.
Peut-on tromper un détecteur de texte IA ?
Les détecteurs de texte IA cherchent des schémas statistiques : constructions répétitives, prévisibilité du mot suivant, absence d'erreurs. Si tu ajoutes de l'irrégularité au texte — différentes longueurs de phrases, tournures inattendues, exemples vivants — le détecteur sera moins certain. Mais il n'y a pas de garantie à 100% de le tromper. La meilleure façon — écrire avec l'IA mais retravailler le texte à ta manière.
Qu'est-ce qu'une fenêtre contextuelle ?
Une fenêtre contextuelle est le nombre maximum de tokens que le modèle peut traiter à la fois. Pour GPT-4, c'est 128 000 tokens (environ 300 pages de texte) ; pour Claude 3.5 — 200 000 ; pour Gemini 1.5 Pro — 1 million. Si le dialogue devient plus long, le modèle commence à "oublier" le début — les premiers messages sortent du contexte.
Conclusion : Maintenant tu vois ce qu'il y a sous le capot
Maintenant quand tu écris un prompt à ChatGPT, tu comprends ce qui se passe à l'intérieur.
Tokenisation — le texte est découpé en morceaux
Embeddings — les morceaux obtiennent du sens par des vecteurs
Mécanisme d'attention — le modèle voit les connexions entre les mots
Transformer — des couches d'analyse du simple au complexe
Génération — la réponse est créée token par token
Pas de magie. Mathématiques, architecture, ingénierie. Des milliards de nombres qui s'additionnent en texte significatif.
Et cette connaissance est utile.
Tu peux écrire de meilleurs prompts. Comprendre les limitations. Ne pas tomber dans les hallucinations. Travailler avec l'IA plus efficacement.
Il y a dix ans, tout ça semblait de la science-fiction. Maintenant — ordinaire. Et dans dix ans ? Ce sera encore plus cool.
Mais les fondations resteront les mêmes. Tokens, vecteurs, attention, transformers.
Comprendre le langage des machines devient une compétence aussi basique que savoir chercher des informations sur Internet.
Et rappelle-toi le vieux principe CodeGym : la meilleure façon d'apprendre est de pratiquer. Expérimente avec les prompts. Essaie différents modèles. Regarde comment ils réagissent.
C'est la seule façon de vraiment comprendre l'IA.
Bonne chance ! 🚀
P.S. Tu veux plonger plus profondément dans les technologies qui changent le monde ? On n'enseigne pas juste la programmation — on te montre comment fonctionnent les outils du futur, des algorithmes de base au travail avec les assistants IA.
En savoir plus :
- Cours de programmation CodeGym — apprendre par la pratique avec des outils modernes
- Cours Java — du niveau débutant au niveau avancé
- Cours Python — le langage pour l'IA et le machine learning
Rejoins des milliers de développeurs qui construisent le futur avec nous.
GO TO FULL VERSION