Jest bug, na który prawie każdy, kto uczy się Pythona, trafia przynajmniej raz. Piszesz numbers = numbers.sort(), uruchamiasz – a w numbers jest None. Lista niby się posortowała i od razu zniknęła.
Python nie jest tu niczemu winny, zrobił dokładnie to, co mu kazano. Po prostu sort i sorted wyglądają jak bliźniaki, a zachowują się inaczej. Wyjaśnijmy to raz na zawsze – a przy okazji przejdźmy przez wszystko, co spotkasz w praktyce: klucze, słowniki, obiekty, kilka pól, polskie znaki i szybkość.
Czym różni się sorted() od sort()
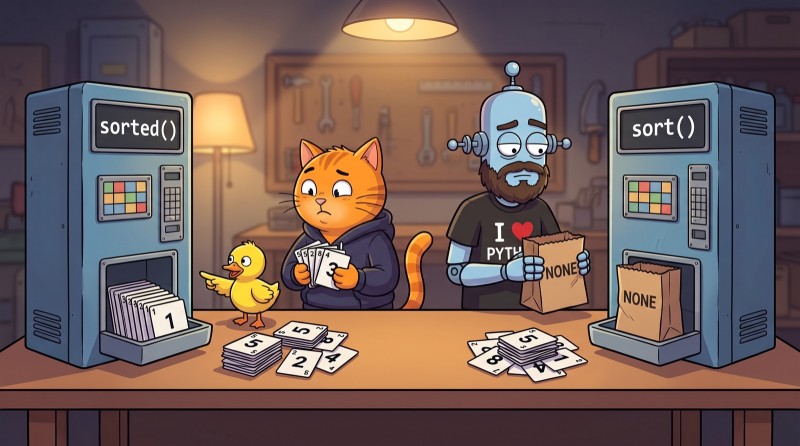
W największym skrócie: sorted() to funkcja, która zwraca nową posortowaną listę i nie rusza oryginalnych danych. list.sort() to metoda listy, która sortuje ją w miejscu i zwraca None.
scores = [42, 7, 19]

fresh = sorted(scores)
print(scores)  # [42, 7, 19] — oryginalna lista bez zmian
print(fresh)   # [7, 19, 42] — to nowa lista

fresh = scores.sort()
print(scores)  # [7, 19, 42] — teraz zmieniła się sama lista
print(fresh)   # None
Oto rozwiązanie zagadki z początku: .sort() posortował listę, zwrócił None – i to None nadpisało zmienną. Zwracanie None to świadoma decyzja twórców Pythona: metoda, która zmienia obiekt, niczego nie zwraca, żeby nikt nie pomylił jej z funkcją tworzącą kopię.
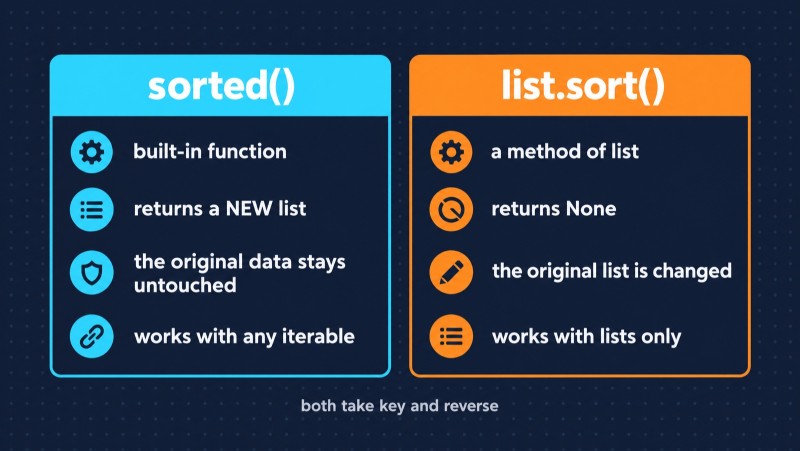
sorted() | list.sort() | |
| Co to jest | funkcja wbudowana | metoda listy |
| Co zwraca | nową listę | None |
| Oryginalne dane | bez zmian | zmieniają się |
| Z czym działa | z dowolnym obiektem iterowalnym: listą, krotką, napisem, słownikiem, zbiorem | tylko z listą |
| Kiedy używać | potrzebujesz oryginału albo to nie jest lista | lista jest duża, a oryginał niepotrzebny |
Ważny szczegół: sorted() zawsze zwraca listę, cokolwiek jej podasz.
sorted((3, 1, 2))       # [1, 2, 3] — z krotki powstała lista
sorted("python")        # ['h', 'n', 'o', 'p', 't', 'y']
"".join(sorted("python"))  # 'hnopty'
Sortowanie malejąco: reverse
Oba narzędzia mają te same parametry: key i reverse. Można je przekazywać tylko po nazwie – numbers.sort(True) rzuci TypeError.
cities = ["Wrocław", "Gdańsk", "Kraków"]

sorted(cities)                # ['Gdańsk', 'Kraków', 'Wrocław']
sorted(cities, reverse=True)  # ['Wrocław', 'Kraków', 'Gdańsk']
Sortowanie po kluczu: parametr key
key to najważniejszy parametr sortowania. Przekazujesz funkcję, Python wywołuje ją dla każdego elementu i sortuje według tego, co zwróciła. Same elementy się nie zmieniają.
Weźmy listę pracowników – będziemy z nią pracować dalej:
employees = [
    {"name": "Marta", "dept": "Dev", "salary": 4200},
    {"name": "Darek", "dept": "QA", "salary": 2600},
    {"name": "Kasia", "dept": "Dev", "salary": 3100},
    {"name": "Karol", "dept": "Design", "salary": 2900},
]
lambda – do szybkich kluczy
by_salary = sorted(employees, key=lambda e: e["salary"])itemgetter i attrgetter – to samo, ale szybciej
W module operator są gotowe funkcje do pobierania pola słownika i atrybutu obiektu. Są napisane w C, więc działają szybciej niż lambda.
from operator import itemgetter

by_salary = sorted(employees, key=itemgetter("salary"))
O ile szybciej? Zmierzyliśmy to na najnowszym Pythonie 3.15 i stu tysiącach słowników: itemgetter wyprzedził lambdę o mniej więcej 10%. Miło, ale to nie rewolucja – na krótkich listach nie zauważysz różnicy. Używaj itemgetter, gdy sortujesz dużo i często, a lambdy – gdy tak jest czytelniej.
Gotowe funkcje i metody
Do key możesz przekazać dowolną funkcję z jednym argumentem, także wbudowaną. Najważniejsze: przekazujesz samą funkcję, bez nawiasów.
words = ["banana", "kiwi", "Cherry"]

sorted(words)                 # ['Cherry', 'banana', 'kiwi'] — wielkie litery idą pierwsze
sorted(words, key=str.lower)  # ['banana', 'Cherry', 'kiwi'] — bez rozróżniania wielkości liter
sorted(words, key=len)        # ['kiwi', 'banana', 'Cherry'] — po długości
Sortowanie po kilku polach
Klucz-krotka
Jeśli key zwraca krotkę, Python porównuje ją element po elemencie: najpierw pierwszą wartość, przy równości – drugą i tak dalej. Żeby jedno z pól liczbowych szło malejąco, stawiamy przed nim minus.
# po dziale, a w obrębie działu po pensji od najwyższej do najniższej
result = sorted(employees, key=lambda e: (e["dept"], -e["salary"]))
Dwa przebiegi – gdy minusa nie da się postawić
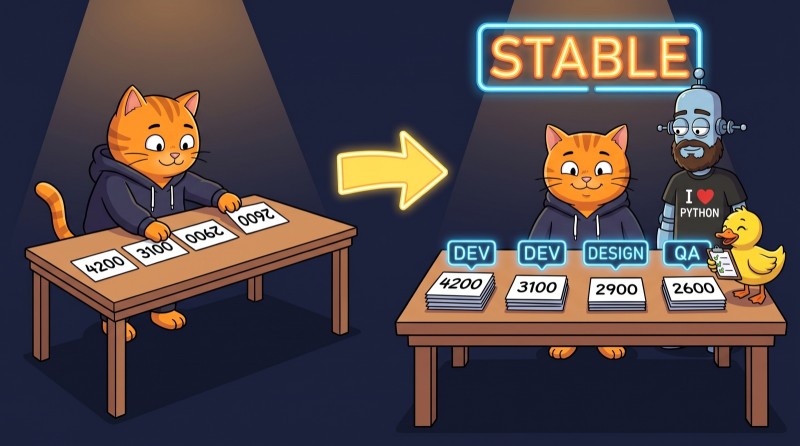
Minus działa tylko z liczbami. Jeśli malejąco trzeba posortować napis, ratuje stabilność: sortowanie w Pythonie nigdy nie zmienia kolejności elementów o tym samym kluczu. Dlatego można sortować w dwóch przebiegach – najpierw po polu drugorzędnym, potem po głównym.
from operator import itemgetter

# 1. pole drugorzędne: pensja malejąco
step1 = sorted(employees, key=itemgetter("salary"), reverse=True)
# 2. pole główne: dział alfabetycznie — kolejność pensji w obrębie działu zostanie zachowana
result = sorted(step1, key=itemgetter("dept"))
Przyjęło się, że krotka jest szybsza, bo przebieg jest jeden. Sprawdziliśmy na tych samych stu tysiącach słowników – i dwa przebiegi z itemgetter okazały się mniej więcej półtora raza szybsze niż krotka z lambdą: 16 milisekund wobec 27. Utworzenie stu tysięcy krotek i porównywanie ich element po elemencie też kosztuje. Morał jest prosty: wybieraj to, co czyta się jaśniej, a o szybkości myśl wtedy, gdy pomiar pokaże problem.
Jak posortować słownik po wartości
Samego słownika posortować się nie da, ale można dostać posortowane klucze albo pary i zbudować z nich nowy słownik – od Pythona 3.7 słowniki zachowują kolejność wstawiania.
grades = {"Tomek": 72, "Ewa": 95, "Olek": 88}

sorted(grades)  # ['Ewa', 'Olek', 'Tomek'] — same klucze

# po wartości, od największej do najmniejszej
top = dict(sorted(grades.items(), key=lambda kv: kv[1], reverse=True))
print(top)  # {'Ewa': 95, 'Olek': 88, 'Tomek': 72}
Potrzebujesz tylko najlepszych N? Nie sortuj wszystkiego
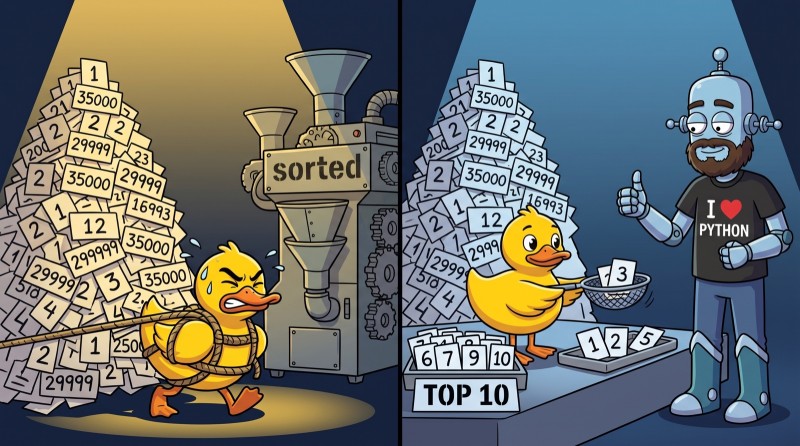
Częste zadanie: znaleźć 10 największych wartości. Pierwszy pomysł: posortować i wziąć wycinek. Ale sortowanie miliona elementów dla dziesięciu to marnotrawstwo. Do tego służy moduł heapq:
import heapq

top10 = heapq.nlargest(10, numbers)
cheapest = heapq.nsmallest(3, products, key=lambda p: p["price"])
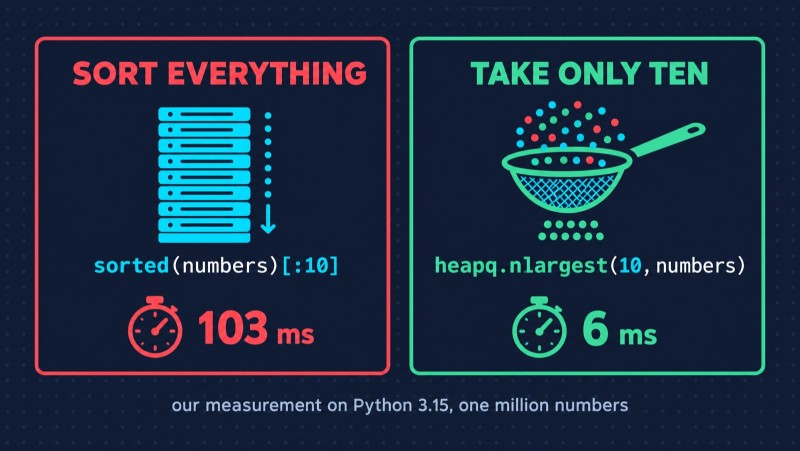
W naszym pomiarze na liście miliona liczb heapq.nlargest(10, ...) był prawie 18 razy szybszy niż sorted(...)[:10]: 6 milisekund wobec 103.
Sortowanie obiektów
Jeśli dane są w obiektach, klucz buduje się tak samo, tylko przez attrgetter:
from dataclasses import dataclass
from operator import attrgetter

@dataclass
class Employee:
    name: str
    salary: int

staff = [Employee("Marta", 4200), Employee("Darek", 2600)]
sorted(staff, key=attrgetter("salary"))
A jeśli obiekty mają być zawsze sortowane tak samo, naucz je się porównywać: dla dataclass wystarczy @dataclass(order=True) – porównanie pójdzie po polach w kolejności deklaracji.
Pięć pułapek, na których sortowanie się sypie
1. None na liście
sorted([3, None, 1])
# TypeError: '<' not supported between instances of 'NoneType' and 'int'
Python 3 nie potrafi porównać None z liczbami. Rozwiązanie to klucz, który wysyła None na koniec:
sorted([3, None, 1], key=lambda x: (x is None, x)) # [1, 3, None]2. Różne typy
sorted([3, "2", 1]) wywali się z tym samym błędem: napisu nie da się porównać z liczbą. Zwykle oznacza to, że dane przyszły „brudne”, na przykład z CSV. Sprowadzaj je do jednego typu przed sortowaniem, a nie w jego trakcie.
3. Liczby w napisach
files = ["file10.txt", "file2.txt", "file1.txt"]
sorted(files)  # ['file1.txt', 'file10.txt', 'file2.txt']
Napisy porównuje się znak po znaku, a „1” w „10” jest mniejsze niż „2”. Żeby dostać kolejność, której spodziewa się człowiek – tak zwane sortowanie naturalne – rozbij napis na tekst i liczby:
import re

def natural_key(s):
    return [int(part) if part.isdigit() else part.lower()
            for part in re.split(r"(\d+)", s)]

sorted(files, key=natural_key)  # ['file1.txt', 'file2.txt', 'file10.txt']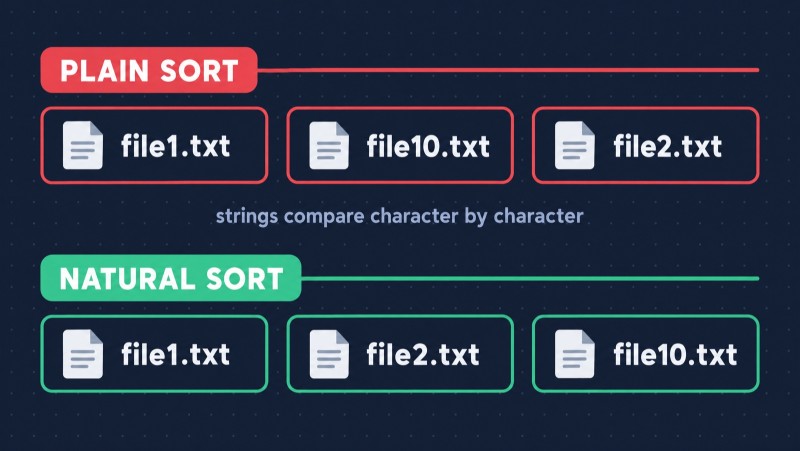
4. Polskie znaki
A oto pułapka, o której nie piszą anglojęzyczne tutoriale:
sorted(["żaba", "zebra", "łódź", "lis", "ćma", "cel"]) # ['cel', 'lis', 'zebra', 'ćma', 'łódź', 'żaba']Ćma, łódź i żaba wylądowały za zebrą. Python porównuje napisy według kodów Unicode, a ą, ć, ę, ł, ń, ó, ś, ź i ż nie stoją w tabeli obok a, c, e czy l, tylko daleko za z. Z wielkimi literami jest tak samo: „Z” idzie przed małym „a”.
Do sortowania według reguł języka służy moduł locale:
import locale

locale.setlocale(locale.LC_COLLATE, "pl_PL.UTF-8")
sorted(["żaba", "zebra", "łódź", "lis", "ćma", "cel"], key=locale.strxfrm)  # ['cel', 'ćma', 'lis', 'łódź', 'zebra', 'żaba']
Haczyk: wynik zależy od tego, jakie locale są zainstalowane w systemie, a na Windowsie nazywają się inaczej. Jeśli w produkcji trzeba sortować po ludzku, pewniejsza jest biblioteka PyICU – działa wszędzie tak samo.
5. Przypisanie wyniku sort
Ten sam bug z początku. x = x.sort() to zawsze None. Albo x.sort() w osobnej linii, albo x = sorted(x).
Co jest pod maską
Sortowanie w Pythonie to nie podręcznikowe „bąbelkowe”, tylko hybrydowy algorytm dopasowany do prawdziwych danych. Od wersji 2.3 był to Timsort, a w Pythonie 3.11 jego strategię scalania zastąpiono Powersortem – solidniejszym, z udowodnionymi gwarancjami.
Co ważne w praktyce:
- Złożoność to O(n log n) w najgorszym przypadku.
- Sortowanie jest stabilne, co gwarantuje dokumentacja. Na tym opiera się trik z dwoma przebiegami.
- Prawie posortowane dane sortują się bardzo szybko. Algorytm znajduje już uporządkowane fragmenty i po prostu je skleja. W naszym pomiarze już posortowana lista miliona liczb sortowała się mniej więcej 9 razy szybciej niż przetasowana.
Wszystkie pomiary robiliśmy na Pythonie 3.15.1, na laptopie z Apple Silicon. Na innym sprzęcie bezwzględne liczby będą inne, ale proporcje zwykle się utrzymują. Chcesz sprawdzić u siebie? Wystarczy moduł timeit i pięć linijek kodu.
Po co to wiedzieć, skoro kod pisze AI

Uczciwe pytanie. Poproś dowolną AI o posortowanie listy słowników po pensji – dostaniesz działający kod w sekundę. Ale AI z tą samą pewnością napisze data = data.sort(), nie pomyśli o None w danych z bazy i posortuje nazwiska na „Ł” czy „Ż” w złym miejscu. Kod będzie wyglądał poprawnie i przejdzie pobieżny rzut oka.
Taki błąd zauważy tylko ktoś, kto rozumie, jak działa sortowanie. Na tym polega różnica między kimś, kto korzysta z AI, a kimś, kogo AI czyni wielokrotnie silniejszym: narzędzie przyspiesza tego, kto ma podstawy.
Podstawy Pythona buduje się praktyką, nie czytaniem. Nasz kurs Pythona w CodeGym to ponad 52 poziomy zadań z natychmiastowym sprawdzaniem oraz osobne poziomy z algorytmów i struktur danych – gdzie sortowanie rozbiera się od środka, a nie na poziomie „wywołaj sorted”. Jeśli nie wiesz, od czego zacząć z Pythonem w ogóle, zajrzyj do naszej roadmapy programisty Pythona 2026.
Najczęstsze pytania
Czym różni się sort() od sorted() w Pythonie? sorted() to funkcja wbudowana: przyjmuje dowolny obiekt iterowalny i zwraca nową posortowaną listę, nie zmieniając oryginalnych danych. list.sort() to metoda listy: sortuje listę w miejscu i zwraca None.
Dlaczego list.sort() zwraca None? To świadoma decyzja twórców Pythona: metody, które zmieniają obiekt w miejscu, zwracają None, żeby nie mylić ich z funkcjami tworzącymi nowy obiekt. Dlatego x = x.sort() zapisuje w zmiennej None.
Jak posortować listę malejąco w Pythonie? Przekazać parametr reverse=True: sorted(data, reverse=True) albo data.sort(reverse=True).
Jak posortować słownik po wartości w Pythonie? Posortować pary po drugim elemencie i zbudować nowy słownik: dict(sorted(d.items(), key=lambda kv: kv[1])). Dla kolejności malejącej dodać reverse=True.
Jak posortować listę po kilku polach? Przekazać do key funkcję, która zwraca krotkę: key=lambda e: (e["dept"], -e["salary"]). Jeśli pola nie da się odwrócić minusem, na przykład napisu, posortować w dwóch przebiegach: najpierw po polu drugorzędnym, potem po głównym – stabilność sortowania zachowa kolejność.
Jakiego algorytmu sortowania używa Python? Do wersji 3.10 włącznie – Timsort, od Pythona 3.11 – jego ulepszonej wersji Powersort. Oba są hybrydowe, stabilne, działają w O(n log n) i są szczególnie szybkie na częściowo uporządkowanych danych.
GO TO FULL VERSION