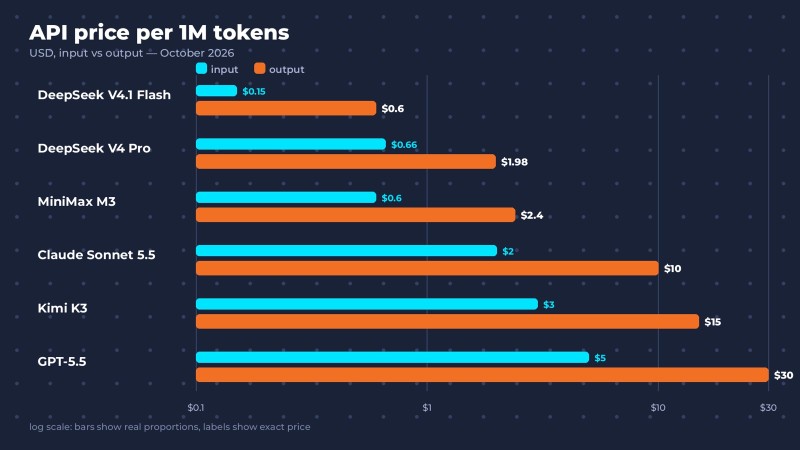
Milion tokenów wyjściowych GPT-5.5 przez API kosztuje 30 $. W Claude Sonnet 5.5 – 10 $. W DeepSeek V4.1 Flash – od 0,60 $.
To nie literówka. Różnica jest kilkudziesięciokrotna. Do tego model DeepSeek można pobrać w całości i uruchomić na własnym serwerze, bo jego wagi opublikowano na licencji MIT. Choćby jutro wbudujesz go w produkt.
Brzmi jak reklama naciągaczy z mediów społecznościowych. Ale to rzeczywistość 2026 roku: chińskie laboratoria niemal co miesiąc wypuszczają modele na poziomie zachodnich flagowców i rozdają je za darmo. Programiści na całym świecie już z tego korzystają.
Sprawdźmy, co to za modele, co naprawdę potrafią, jak podłączyć je do Claude Code – i gdzie zaczyna się haczyk. A jest, i to niejeden.
Czym są otwarte modele i dlaczego to ważne
W największym skrócie: otwarty model (open-weight) to sieć neuronowa, której wagi opublikowano do pobrania. Można uruchomić ją na własnym sprzęcie, dotrenować pod swoje zadanie i wbudować w produkt bez subskrypcji i bez wysyłania danych do cudzej chmury.
ChatGPT i Claude to modele zamknięte. Korzystasz z nich tylko przez stronę, aplikację albo API, a sam model żyje na serwerach OpenAI i Anthropic. Otwarty model możesz mieć na własność: pobierasz – i jest twój, na twoich warunkach. Na ile twój, zależy od licencji, ale o tym niżej.
Dlaczego Chińczycy rozdają modele za darmo
Jeszcze kilka lat temu otwarte modele kojarzyły się przede wszystkim z Llamą od Mety. W 2026 roku obraz jest inny. Według wiosennego raportu Hugging Face od lutego 2025 do lutego 2026 na chińskie otwarte modele przypadło 41% wszystkich pobrań na platformie. Na amerykańskie – 36,5%.
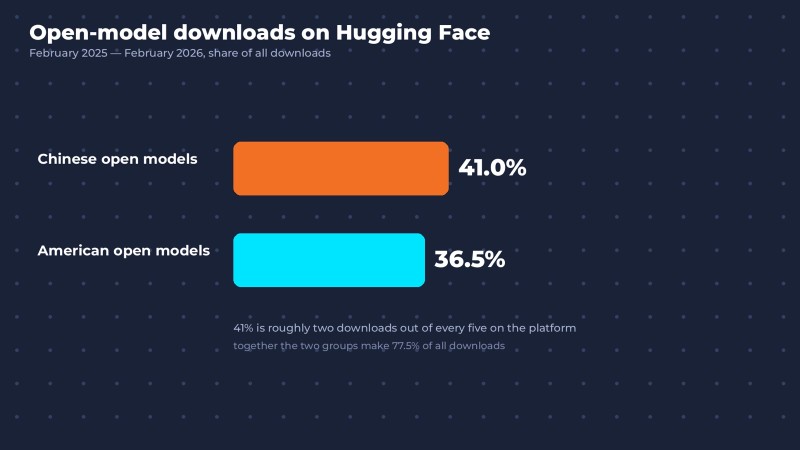
Rodzina Qwen od Alibaby według różnych szacunków przekroczyła miliard pobrań i wyprzedziła Llamę. Na jej bazie ludzie dotrenowali więcej modeli pochodnych niż na bazie jakiejkolwiek innej rodziny.
Dlaczego chińskie firmy rozdają to, za co OpenAI i Anthropic biorą pieniądze? Powodów jest kilka:
- To strategia zdobywania rynku. Kiedy programiści na całym świecie budują produkty na twoim modelu, stajesz się standardem. Pieniądze przychodzą potem – z chmury, od klientów korporacyjnych i z kolejnych modeli.
- Konkurencja wewnątrz Chin. DeepSeek, Alibaba, Moonshot, Zhipu, MiniMax i ByteDance rywalizują tak ostro, że prawie co tydzień ktoś wypuszcza nową wersję.
- Trenowanie stało się tańsze. Chińskie laboratoria nauczyły się trenować mocne modele taniej, także przy ograniczeniach w dostawach amerykańskich chipów.
Dla programisty wniosek jest prosty: wybór modeli w 2026 roku jest większy niż kiedykolwiek, a część tego wyboru jest darmowa.
Najważniejsze chińskie modele AI 2026 roku
Od razu ważne zastrzeżenie. Wersje zmieniają się tu tak szybko, że każdy przegląd starzeje się w ciągu paru miesięcy. Poniżej stan na koniec października 2026 roku.
DeepSeek V4: najtańsze API
Ta sama firma, która w styczniu 2025 roku zatopiła akcje Nvidii. DeepSeek ma teraz dwa główne modele: V4 Pro i V4.1 Flash. Najnowszą wersję Flash wypuszczono 17 października 2026 roku, wagi są otwarte na licencji MIT, a kontekst sięga miliona tokenów.

Mocna strona – cena. Flash kosztuje kilkadziesiąt razy mniej niż zachodnie flagowce, a poza godzinami szczytu jeszcze mniej więcej o połowę mniej. Do automatyzacji w tle, przetwarzania dokumentów i zadań masowych to praktycznie za darmo.
Słaba strona – niezawodność w złożonych zadaniach agentowych. Tom's Hardware, omawiając nowy model, osobno zauważył: oszczędnie gospodaruje pamięcią, ale w scenariuszach agentowych częściej niż zamknięci konkurenci halucynuje.
Qwen 3.8: najpopularniejszy otwarty model
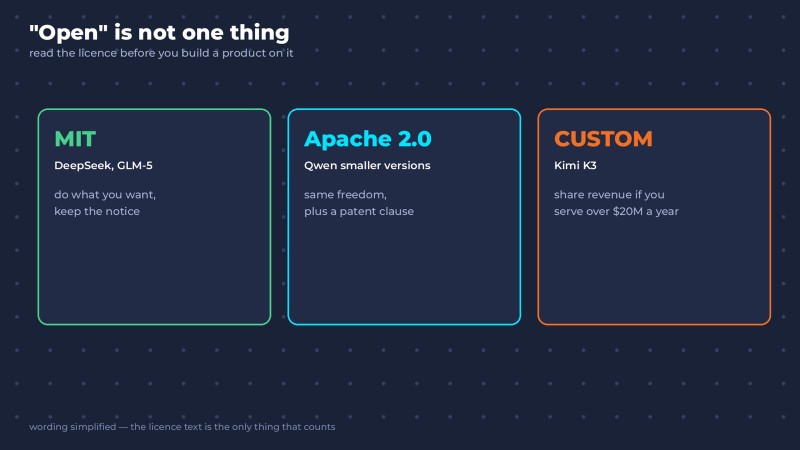
Rodzina modeli od Alibaby. Aktualna generacja to Qwen 3.8, a Qwen 4 według Alibaby jest właśnie trenowany. Największa zaleta Qwena to wybór rozmiarów: od kompaktowych modeli, które realnie uruchomisz na swoim komputerze, po ciężkie flagowce. Mniejsze wersje wychodzą na licencji Apache 2.0, jednej z najbardziej swobodnych.
Jeśli potrzebujesz otwartego modelu, który dotrenujesz pod swoje zadanie, Qwen jest pierwszym kandydatem. Właśnie dlatego na jego bazie powstaje najwięcej modeli pochodnych.
Kimi K3: flagowiec do kodu i agentów
Model od Moonshot AI. K3 wyszedł 16 lipca 2026 roku, a dwa tygodnie później Moonshot opublikował jego wagi. Rozmiar robi wrażenie: 2,8 biliona parametrów i kontekst na milion tokenów. Model jest nastawiony na długie zadania agentowe: poruszanie się po dużych repozytoriach, debugowanie, pracę z narzędziami i logami.
Kimi trafiał już do wiadomości: niedawno w 27 minut znalazł podatność RCE w Redisie.
Niuans – licencja. To nie MIT, tylko własna: dostawcy, którzy na inferencji K3 zarabiają ponad 20 mln $ rocznie, muszą dzielić się przychodem. Ciebie jako programisty raczej to nie dotknie, ale licencję przed użyciem w produkcie warto czytać zawsze.
GLM-5: otwarty model do programowania
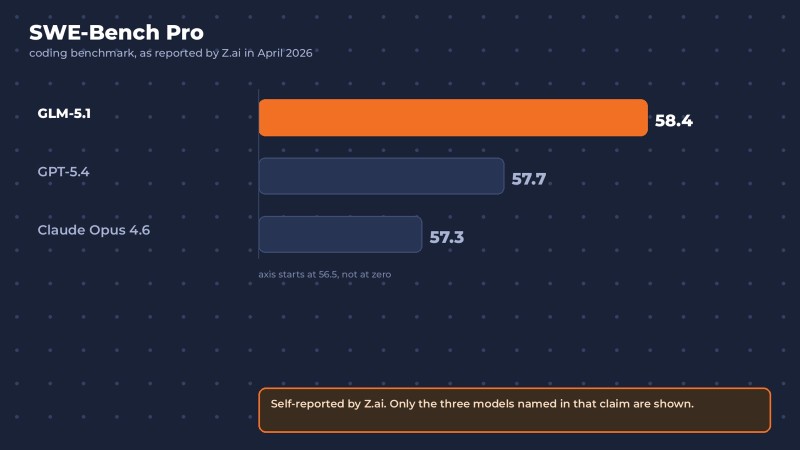
Linia modeli od Z.ai, dawniej Zhipu AI. W kwietniu 2026 roku firma otworzyła wagi GLM-5.1 na licencji MIT i według własnych pomiarów Z.ai model zajął pierwsze miejsce w benchmarku SWE-Bench Pro, wyprzedzając GPT-5.4 i Claude Opus 4.6. Zastrzeżenie: wynik podała sama firma, a od tamtej pory Z.ai wypuściła kilka kolejnych wersji – wydania pojawiają się niemal co miesiąc.
Dla programistów Z.ai ma osobny GLM Coding Plan – subskrypcję od 18 $ miesięcznie, która działa bezpośrednio w Claude Code. Więcej o tym niżej.
MiniMax M3: milion tokenów i multimodalność
Model od MiniMax, wydany latem 2026 roku z otwartymi wagami. Firma stawia na połączenie trzech rzeczy w jednym modelu: mocnego kodowania, kontekstu na milion tokenów i natywnej pracy z obrazami. Dobra opcja, gdy trzeba dać modelowi naraz dużą porcję dokumentacji albo kodu.
Seedream i Seedance: obrazy i wideo od ByteDance
Chińskie firmy są mocne nie tylko w modelach tekstowych. ByteDance – twórca TikToka – robi generatory obrazów i wideo, które konkurują z najlepszymi zachodnimi.
Seedream 5.0 to generator obrazów. ByteDance wypuścił go w lutym 2026 roku jako tańszą alternatywę dla Nano Banana Pro od Google, a latem dodał wersję Pro. Model generuje obrazy w 2K i 4K, edytuje je na podstawie referencji, a w wersji Lite przed generowaniem nawet szuka informacji w internecie. Przez OpenRouter jeden obraz Seedream 5.0 Pro kosztuje około 0,045 $.
Seedance 2.0 to generator wideo. Od wiosny 2026 roku jest wbudowany bezpośrednio w CapCut i Dreamina, a w Dreaminie pojawiła się już wersja 2.5, która generuje klipy do 30 sekund. Dla programistów jest API przez BytePlus.
Po co to programiście? Bo produkt to nie tylko kod. Ikony, ilustracje na landing page, assety do gry, filmik demo na premierę – kiedyś do tego wszystkiego potrzebny był grafik, montażysta i budżet. Dziś pierwszą wersję złożysz w jeden wieczór. Jedna osoba z kodem i takimi narzędziami wypuszcza to, co kiedyś wymagało małego zespołu.
Porównanie: który model wybrać
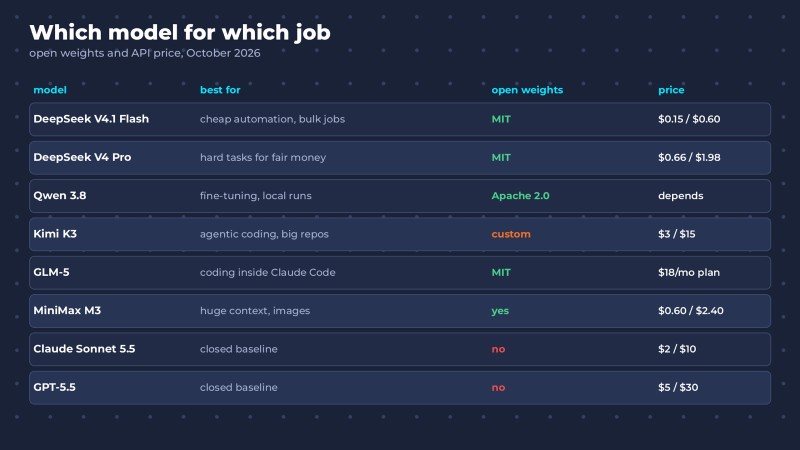
| Model | Najlepszy do | Otwarte wagi | Cena API (za 1 mln tokenów, wejście / wyjście) |
| DeepSeek V4.1 Flash | Tania automatyzacja, zadania masowe | Tak, MIT | od 0,15 $ / 0,60 $ |
| DeepSeek V4 Pro | Trudne zadania za umiarkowane pieniądze | Tak, MIT | około 0,66 $ / 1,98 $ |
| Qwen 3.8 | Dotrenowanie, uruchamianie lokalne, wybór rozmiarów | Tak, mniejsze wersje na Apache 2.0 | zależy od rozmiaru i dostawcy |
| Kimi K3 | Agentowe kodowanie, duże repozytoria | Tak, własna licencja | 3 $ / 15 $ |
| GLM-5 | Kodowanie, praca w Claude Code | Tak, MIT | Coding Plan od 18 $/mies. |
| MiniMax M3 | Ogromny kontekst, obrazy + kod | Tak | około 0,60 $ / 2,40 $ |
| Dla porównania: Claude Sonnet 5.5 | — | Nie | 2 $ / 10 $ |
| Dla porównania: GPT-5.5 | — | Nie | 5 $ / 30 $ |
Chińscy dostawcy często zmieniają ceny, zdarzają się promocje na start i różne stawki w godzinach szczytu i poza nimi. Zanim zaplanujesz koszty w produkcie, sprawdź oficjalną stronę z cennikiem.
Jak podłączyć chiński model do Claude Code
A teraz najbardziej praktyczna część. Claude Code działa nie tylko z modelami Claude. Wysyła zapytania pod adres ze zmiennej środowiskowej ANTHROPIC_BASE_URL, a DeepSeek, Moonshot i Z.ai zrobiły u siebie API zgodne z formatem Anthropic.
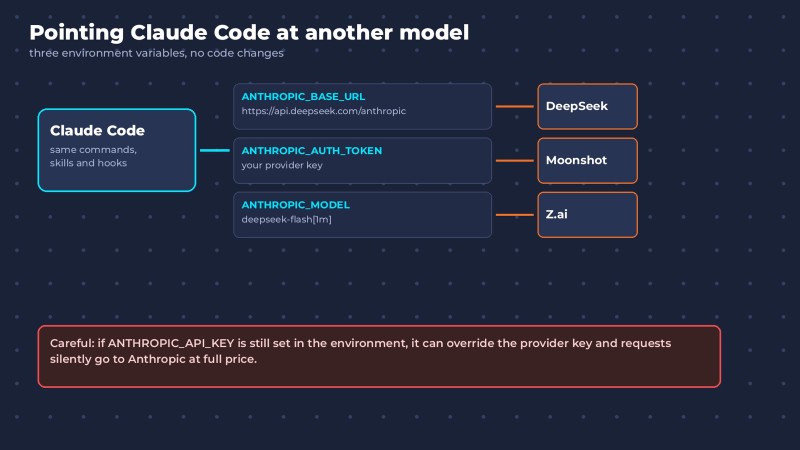
Oto oficjalna konfiguracja z dokumentacji DeepSeek:
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=<twój klucz API DeepSeek>
export ANTHROPIC_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
claude
Sufiks [1m] włącza kontekst na milion tokenów. Jeśli w ustawieniach zostawisz nazwy modeli Claude, DeepSeek sam przekieruje zapytania: Opus – na V4 Pro, Sonnet i Haiku – na Flash.
Potem Claude Code działa jak zwykle – te same polecenia, te same skille, te same subagenty – ale myśli za niego DeepSeek. Moonshot dla Kimi K3 i Z.ai dla GLM działają według tego samego schematu: własny adres API i własny klucz.
Trzy rzeczy, które warto wiedzieć z góry:
- To nie jest konfiguracja oficjalnie wspierana przez Anthropic. Dokumentują ją sami chińscy dostawcy. Coś może działać inaczej: na przykład chińskie modele nie pojawią się w menu
/model, a to, który model teraz odpowiada, sprawdzisz przez/status. - Pilnuj zmiennej
ANTHROPIC_API_KEY. Jeśli została w środowisku, może nadpisać klucz dostawcy, a zapytania po cichu pójdą do Anthropic po pełnej cenie. - Jakość będzie inna. Claude Code jest dostrojony do modeli Claude. Przy prostych zadaniach różnica jest prawie niezauważalna, przy długich sesjach agentowych – widoczna.
Jak działają sam agent, skille, subagenty i hooki, szczegółowo omawialiśmy w artykule Jak działa agent AI.
Gdzie jest haczyk
Entuzjastyczne recenzje zwykle na tym się kończą. My nie. Oto cztery rzeczy, które warto zrozumieć, zanim przeniesiesz pracę na chiński model.
1. „Uruchom u siebie” to nie o laptopie
Recenzje lubią pisać, że chińskie modele można uruchomić przez Ollamę albo LM Studio prosto na swoim komputerze. Technicznie – tak. W praktyce – tylko małe wersje. Flagowiec GLM-5.1 ma około 744 miliardów parametrów, Kimi K3 – 2,8 biliona. Do tego potrzebny jest nie laptop, tylko szafa serwerowa z kilkoma drogimi kartami graficznymi.
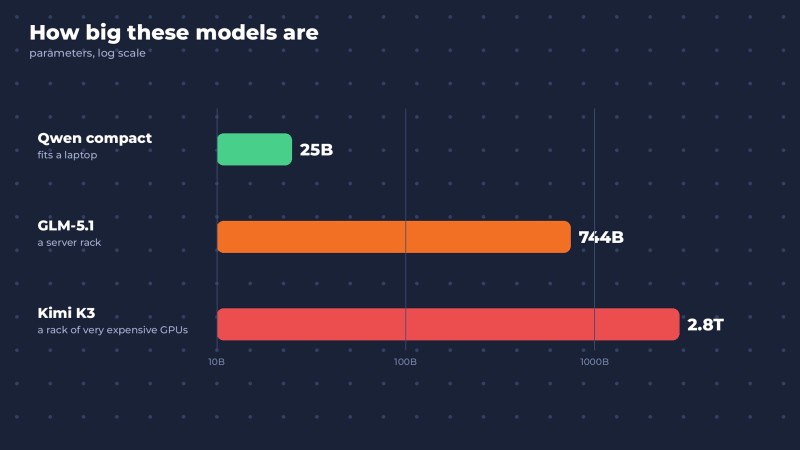
Na zwykłym komputerze realnie działają kompaktowe modele destylowane – na przykład mniejsze wersje Qwena na 20–30 miliardów parametrów. Są przydatne, ale do flagowców nie dorastają.
2. Dokąd trafiają twoje dane
Otwarty model na własnym serwerze to jedno. Chmurowe API chińskiej firmy to coś zupełnie innego. Polityka prywatności DeepSeek mówi wprost, że zapytania i przesłane pliki są przechowywane na serwerach w Chinach. Właśnie dlatego Australia zakazała DeepSeek na urządzeniach rządowych, włoski regulator zażądał usunięcia aplikacji ze sklepów, a Czechy i Tajwan zakazały jej w instytucjach państwowych.
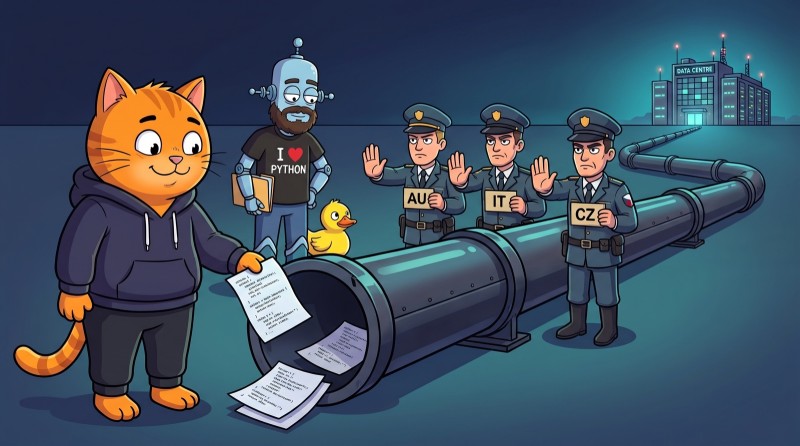
Praktyczna zasada: prywatny projekt po godzinach przez chińskie API – proszę bardzo. Kod firmy, klucze, dane klientów – tylko przez uruchomienie lokalne albo przez zachodniego dostawcę, który hostuje otwarte wagi u siebie. Wagi te same, a dane zostają pod twoją kontrolą.
3. AI-śmieci nikt nie odwołał
Tani model myli się nie rzadziej niż drogi, a czasem częściej. Przy złożonej logice i długich zadaniach agentowych chińskie modele wyraźnie częściej z pewnością siebie oddają niedziałający kod albo wymyślają nieistniejące metody. Benchmarki publikowane przez same firmy warto dzielić na dwa: mierzą to, co wygodnie zmierzyć.
4. „Otwarty” nie znaczy „rób, co chcesz”
MIT i Apache 2.0 to naprawdę swobodne licencje. Ale Kimi K3 ma licencję własną, z warunkami dla dużych komercyjnych dostawców. Zanim zbudujesz na modelu produkt, poświęć dziesięć minut i przeczytaj licencję. To tańsze niż późniejsza przebudowa architektury.
Co to oznacza dla programisty
Jest stara myśl, do której ciągle wracamy: narzędzia się zerują, podstawy zostają. Chińskie modele pokazują to najwyraźniej.
Rok temu dostęp do mocnego modelu był przewagą. Dziś model na poziomie flagowca dostaniesz za darmo, a za miesiąc wyjdzie kolejny – też za darmo. Modele stają się surowcem, jak prąd. Nikt nie chwali się tym, że ma prąd w gniazdku.
Wartość przesuwa się do tego, kto umie z tego prądu korzystać. Dobrać model do zadania i budżetu. Podłączyć go do agenta. Sprawdzić, co napisał – i zauważyć, gdzie z pewnością siebie się pomylił. Ustawić uprawnienia tak, żeby agent niczego nie narobił. To właśnie umiejętność, za którą się płaci. I nie traci ona na wartości, gdy wychodzi kolejny model – wręcz przeciwnie, drożeje.

Najlepszy model to nie ten, który jest wyżej w benchmarku, tylko ten, którego wynik umiesz sprawdzić.
Gdzie się tego nauczyć
Praca z agentami w taki sposób, by nie zależeć od jednego konkretnego modelu, to dokładnie to, czemu poświęcony jest nasz kurs Programowanie z Claude Code od AI Academy. 16 poziomów i 200+ zadań: uprawnienia i kontekst, skille, subagenty, MCP, hooki, plan mode i kontrola przez gita. Wszystko to działa tak samo, niezależnie od tego, jaki model jest pod maską.
A jeśli dopiero zaczynasz programować, zacznij od podstaw: żeby sprawdzić, co pisze model, trzeba samemu umieć czytać kod. Właśnie to ćwiczy nasz kurs Pythona – tysiące zadań z natychmiastowym sprawdzaniem.
Najczęstsze pytania
Jakie chińskie modele AI są najlepsze w 2026 roku? Na koniec października 2026 roku najważniejsze to DeepSeek V4 (najtańsze API), Qwen 3.8 od Alibaby (najpopularniejszy otwarty model), Kimi K3 od Moonshot AI (agentowe kodowanie i duże repozytoria), linia GLM-5 od Z.ai (kodowanie, praca w Claude Code) i MiniMax M3 (kontekst na milion tokenów i multimodalność). Do obrazów i wideo – Seedream 5.0 i Seedance 2.0 od ByteDance.
Czy chińskie modele AI mogą zastąpić ChatGPT i Claude? W wielu zadaniach tak: automatyzacja, przetwarzanie dokumentów, generowanie kodu średniej złożoności. Przy złożonej logice i długich scenariuszach agentowych chińskie modele wciąż częściej się mylą. Główne zalety to ceny API kilkadziesiąt razy niższe i możliwość uruchomienia modelu na własnym serwerze.
Ile kosztuje API chińskich modeli AI? DeepSeek V4.1 Flash kosztuje od 0,15 $ za milion tokenów wejściowych i 0,60 $ za milion wyjściowych. Kimi K3 – 3 $ i 15 $. Dla porównania: Claude Sonnet 5.5 – 2 $ i 10 $, GPT-5.5 – 5 $ i 30 $. Ceny często się zmieniają, więc sprawdzaj oficjalne cenniki dostawców.
Czy mogę uruchomić chiński model AI na swoim komputerze? Tylko kompaktowe wersje – na przykład mniejsze modele Qwen na 20–30 miliardów parametrów przez Ollamę albo LM Studio. Flagowce takie jak GLM-5.1 (około 744 miliardów parametrów) czy Kimi K3 (2,8 biliona) wymagają sprzętu serwerowego z kilkoma mocnymi kartami graficznymi.
Czy wysyłanie kodu do chińskich modeli AI jest bezpieczne? Przez chmurowe API – ostrożnie: na przykład DeepSeek przechowuje zapytania i pliki na serwerach w Chinach, dlatego kilka krajów zakazało go na urządzeniach rządowych. Dla kodu firmowego i danych klientów bezpieczniej jest uruchamiać otwarte wagi lokalnie albo przez zachodniego dostawcę, który hostuje je u siebie.
Jak podłączyć DeepSeek albo Kimi do Claude Code? Przez zmienne środowiskowe: ustawić ANTHROPIC_BASE_URL na adres dostawcy zgodny z Anthropic (na przykład https://api.deepseek.com/anthropic), klucz dostawcy w ANTHROPIC_AUTH_TOKEN i nazwę modelu w ANTHROPIC_MODEL. To konfiguracja udokumentowana przez dostawców, ale nieoficjalnie wspierana przez Anthropic.
GO TO FULL VERSION