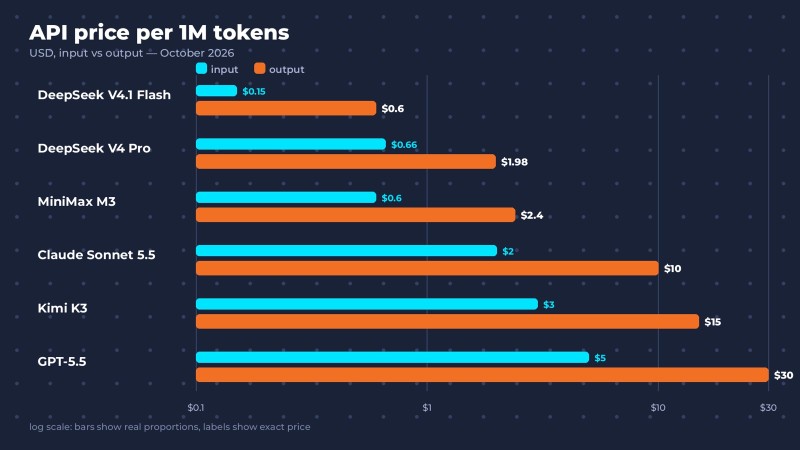
Eine Million Ausgabe-Tokens von GPT-5.5 kostet über die API 30 $. Bei Claude Sonnet 5.5 sind es 10 $. Bei DeepSeek V4.1 Flash ab 0,60 $.
Das ist kein Tippfehler. Der Unterschied liegt beim Zehnfachen und mehr. Dazu kannst du das DeepSeek-Modell komplett herunterladen und auf deinem eigenen Server betreiben, weil seine Gewichte unter der MIT-Lizenz veröffentlicht sind. Du könntest es morgen in ein Produkt einbauen.
Klingt nach Abzocke aus dem Social-Media-Feed. Ist aber die Realität 2026: Chinesische Labore veröffentlichen fast jeden Monat Modelle auf dem Niveau westlicher Flaggschiffe und verschenken sie. Entwickler weltweit nutzen sie längst.
Schauen wir uns an, was das für Modelle sind, was sie wirklich können, wie du sie mit Claude Code verbindest – und wo der Haken ist. Den gibt es, und zwar nicht nur einen.
Was offene Modelle sind und warum das wichtig ist
Kurz gesagt: Ein offenes Modell (Open-Weight) ist ein neuronales Netz, dessen Gewichte zum Download veröffentlicht sind. Du kannst es auf eigener Hardware betreiben, für deine Aufgabe nachtrainieren und ohne Abo in ein Produkt einbauen – ohne Daten in eine fremde Cloud zu schicken.
ChatGPT und Claude sind geschlossene Modelle. Du nutzt sie nur über Website, App oder API, das Modell selbst lebt auf den Servern von OpenAI und Anthropic. Ein offenes Modell kannst du tatsächlich besitzen: herunterladen – und es gehört dir, zu deinen Bedingungen. Wie sehr es dir gehört, hängt von der Lizenz ab, dazu später mehr.
Warum chinesische Labore ihre Modelle verschenken
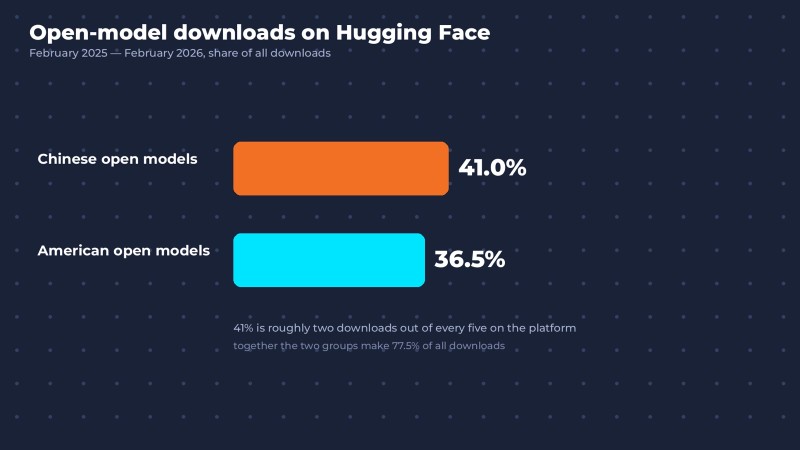
Vor ein paar Jahren standen offene Modelle vor allem für Llama von Meta. 2026 sieht das anders aus. Laut dem Frühjahrsbericht von Hugging Face entfielen zwischen Februar 2025 und Februar 2026 41 % aller Downloads auf der Plattform auf chinesische offene Modelle. Auf amerikanische 36,5 %.
Die Qwen-Familie von Alibaba hat nach verschiedenen Schätzungen die Marke von einer Milliarde Downloads überschritten und Llama überholt. Auf ihrer Basis wurden mehr abgeleitete Modelle trainiert als auf jeder anderen Familie.
Warum verschenken chinesische Firmen, wofür OpenAI und Anthropic Geld verlangen? Es gibt mehrere Gründe:
- Es ist eine Strategie zur Markteroberung. Wenn Entwickler weltweit Produkte auf deinem Modell bauen, wirst du zum Standard. Das Geld kommt später – über Cloud, Unternehmenskunden und die nächsten Modelle.
- Wettbewerb innerhalb Chinas. DeepSeek, Alibaba, Moonshot, Zhipu, MiniMax und ByteDance konkurrieren so hart, dass fast jede Woche irgendwer eine neue Version veröffentlicht.
- Training ist billiger geworden. Chinesische Labore haben gelernt, starke Modelle günstiger zu trainieren – auch unter Beschränkungen bei amerikanischen Chips.
Für Entwickler ist das Fazit einfach: Die Auswahl an Modellen ist 2026 größer als je zuvor, und ein Teil davon ist kostenlos.
Die wichtigsten chinesischen KI-Modelle 2026
Gleich ein wichtiger Hinweis. Die Versionen ändern sich hier so schnell, dass jeder Überblick nach ein paar Monaten veraltet ist. Unten der Stand von Ende Oktober 2026.
DeepSeek V4: die günstigste API
Dieselbe Firma, die im Januar 2025 die Nvidia-Aktie abstürzen ließ. Aktuell hat DeepSeek zwei Hauptmodelle: V4 Pro und V4.1 Flash. Die neueste Flash-Version erschien am 17. Oktober 2026, die Gewichte sind unter MIT offen, der Kontext reicht bis zu einer Million Tokens.
Stärke: der Preis. Flash kostet ein Vielfaches weniger als westliche Flaggschiffe und außerhalb der Spitzenzeiten noch etwa die Hälfte. Für Hintergrund-Automatisierung, Dokumentenverarbeitung und Massenaufgaben ist das fast gratis.

Schwäche: Zuverlässigkeit bei komplexen agentischen Aufgaben. Tom's Hardware hob beim Test des neuen Modells eigens hervor: Es geht sparsam mit Speicher um, halluziniert in agentischen Szenarien aber öfter als proprietäre Konkurrenten.
Qwen 3.8: das beliebteste offene Modell
Eine Modellfamilie von Alibaba. Die aktuelle Generation ist Qwen 3.8, Qwen 4 befindet sich laut Alibaba im Training. Die größte Stärke von Qwen ist die Auswahl an Größen: von kompakten Modellen, die du realistisch auf deinem eigenen Rechner laufen lassen kannst, bis zu schweren Flaggschiffen. Kleinere Versionen erscheinen unter Apache 2.0, einer der freiesten Lizenzen.
Wenn du ein offenes Modell brauchst, das du für deine Aufgabe nachtrainieren kannst, ist Qwen der erste Kandidat. Genau deshalb entstehen auf seiner Basis die meisten abgeleiteten Modelle.
Kimi K3: ein Flaggschiff für Code und Agenten
Ein Modell von Moonshot AI. K3 erschien am 16. Juli 2026, zwei Wochen später veröffentlichte Moonshot die Gewichte. Die Größe beeindruckt: 2,8 Billionen Parameter und ein Kontext von einer Million Tokens. Das Modell ist auf lange agentische Aufgaben ausgelegt: Navigation durch große Repositorys, Debugging, Arbeit mit Tools und Logs.
Kimi war schon in den Nachrichten: Kürzlich fand es in 27 Minuten eine RCE-Schwachstelle in Redis.
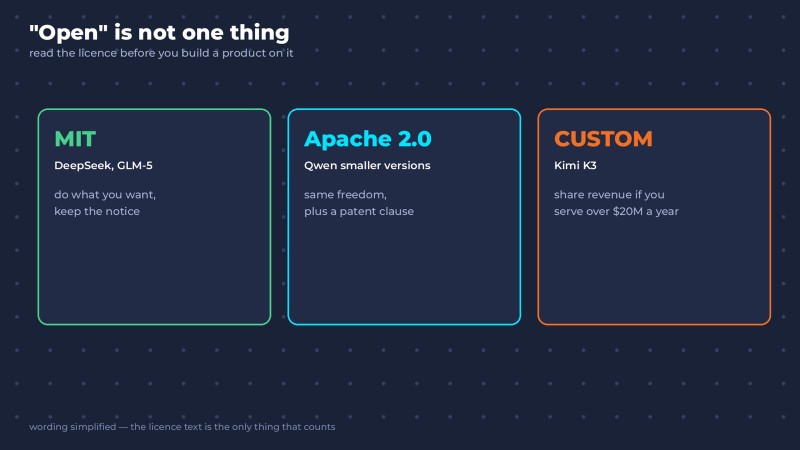
Die Feinheit: die Lizenz. Sie ist nicht MIT, sondern eine eigene: Anbieter, die mit K3-Inferenz mehr als 20 Mio. $ im Jahr verdienen, müssen Umsatz teilen. Dich als Entwickler betrifft das kaum, aber die Lizenz solltest du vor dem Einsatz in einem Produkt immer lesen.
GLM-5: ein offenes Modell fürs Programmieren
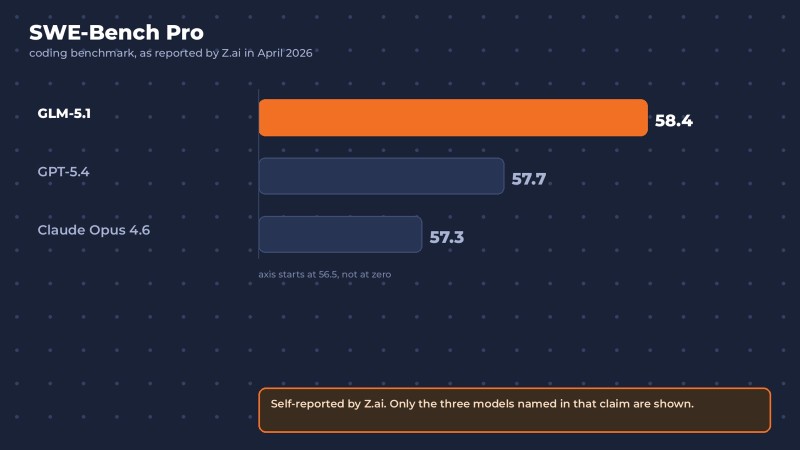
Eine Modellreihe von Z.ai, früher Zhipu AI. Im April 2026 veröffentlichte das Unternehmen die Gewichte von GLM-5.1 unter MIT, und nach eigenen Messungen von Z.ai belegte das Modell Platz eins im Benchmark SWE-Bench Pro, vor GPT-5.4 und Claude Opus 4.6. Einschränkung: Das Ergebnis stammt vom Unternehmen selbst, und Z.ai hat seitdem weitere Versionen veröffentlicht – Releases kommen fast monatlich.
Für Entwickler bietet Z.ai einen eigenen GLM Coding Plan an – ein Abo ab 18 $ im Monat, das direkt in Claude Code funktioniert. Dazu unten mehr.
MiniMax M3: eine Million Tokens und Multimodalität
Ein Modell von MiniMax, im Sommer 2026 mit offenen Gewichten erschienen. Das Unternehmen setzt auf die Kombination von drei Dingen in einem Modell: starkes Coding, eine Million Tokens Kontext und native Bildverarbeitung. Eine gute Wahl, wenn du dem Modell eine große Menge Dokumentation oder Code auf einmal geben willst.
Seedream und Seedance: Bilder und Videos von ByteDance
Chinesische Firmen sind nicht nur bei Textmodellen stark. ByteDance – die Firma hinter TikTok – entwickelt Bild- und Videogeneratoren, die mit den besten westlichen mithalten.
Seedream 5.0 ist ein Bildgenerator. ByteDance brachte ihn im Februar 2026 als günstigere Alternative zu Googles Nano Banana Pro heraus und ergänzte im Sommer eine Pro-Version. Das Modell erzeugt Bilder in 2K und 4K, bearbeitet Bilder anhand von Referenzen und sucht in der Lite-Version vor der Generierung sogar im Internet. Über OpenRouter kostet ein Bild mit Seedream 5.0 Pro etwa 0,045 $.
Seedance 2.0 ist ein Videogenerator. Seit Frühjahr 2026 ist er direkt in CapCut und Dreamina integriert, und bei Dreamina gibt es schon Version 2.5, die Clips bis 30 Sekunden erzeugt. Für Entwickler gibt es eine API über BytePlus.
Warum ist das für Entwickler interessant? Weil ein Produkt nicht nur aus Code besteht. Icons, Illustrationen für die Landingpage, Assets für ein Spiel, ein Demo-Video zum Launch – früher brauchte man dafür einen Designer, einen Videoeditor und Budget. Heute baust du eine erste Version an einem Abend. Eine Person mit Code und solchen Werkzeugen bringt heraus, wofür früher ein kleines Team nötig war.
Vergleich: welches Modell wählen
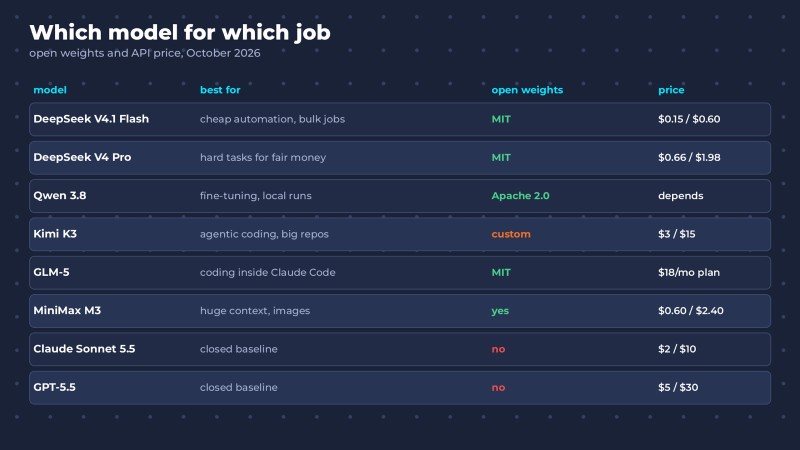
| Modell | Am besten für | Offene Gewichte | API-Preis (pro 1 Mio. Tokens, Eingabe / Ausgabe) |
| DeepSeek V4.1 Flash | Günstige Automatisierung, Massenaufgaben | Ja, MIT | ab 0,15 $ / 0,60 $ |
| DeepSeek V4 Pro | Schwierige Aufgaben für moderates Geld | Ja, MIT | etwa 0,66 $ / 1,98 $ |
| Qwen 3.8 | Nachtraining, lokaler Betrieb, Größenauswahl | Ja, kleinere Versionen unter Apache 2.0 | abhängig von Größe und Anbieter |
| Kimi K3 | Agentisches Coding, große Repositorys | Ja, eigene Lizenz | 3 $ / 15 $ |
| GLM-5 | Coding, Arbeit in Claude Code | Ja, MIT | Coding Plan ab 18 $/Monat |
| MiniMax M3 | Riesiger Kontext, Bilder + Code | Ja | etwa 0,60 $ / 2,40 $ |
| Zum Vergleich: Claude Sonnet 5.5 | — | Nein | 2 $ / 10 $ |
| Zum Vergleich: GPT-5.5 | — | Nein | 5 $ / 30 $ |
Chinesische Anbieter ändern ihre Preise oft, es gibt Startrabatte und unterschiedliche Tarife für Spitzen- und Nebenzeiten. Bevor du Kosten in ein Produkt einplanst, prüfe die offizielle Preisseite.
Wie du ein chinesisches Modell in Claude Code nutzt
Jetzt zum praktischsten Teil. Claude Code arbeitet nicht nur mit Claude-Modellen. Es schickt Anfragen an die Adresse aus der Umgebungsvariable ANTHROPIC_BASE_URL, und DeepSeek, Moonshot und Z.ai haben APIs gebaut, die mit dem Anthropic-Format kompatibel sind.
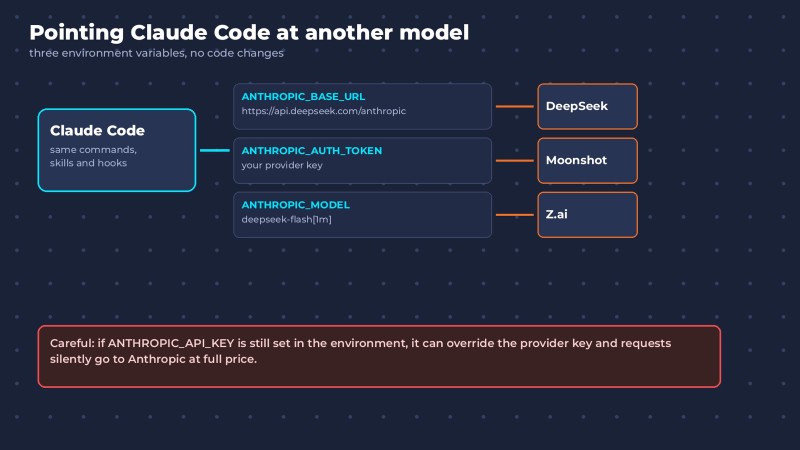
Hier die offizielle Einrichtung aus der Dokumentation von DeepSeek:
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=<dein DeepSeek-API-Schlüssel>
export ANTHROPIC_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
claude
Das Suffix [1m] aktiviert den Kontext von einer Million Tokens. Lässt du in den Einstellungen die Namen der Claude-Modelle stehen, leitet DeepSeek die Anfragen selbst um: Opus auf V4 Pro, Sonnet und Haiku auf Flash.
Danach funktioniert Claude Code wie gewohnt – dieselben Befehle, dieselben Skills, dieselben Subagents –, aber das Denken übernimmt DeepSeek. Moonshot für Kimi K3 und Z.ai für GLM folgen demselben Schema: eigene API-Adresse und eigener Schlüssel.
Drei Dinge, die du vorher wissen solltest:
- Das ist keine von Anthropic offiziell unterstützte Konfiguration. Die chinesischen Anbieter dokumentieren sie selbst. Manches kann anders funktionieren: Zum Beispiel tauchen chinesische Modelle nicht im Menü
/modelauf, und welches Modell gerade antwortet, prüfst du mit/status. - Achte auf die Variable
ANTHROPIC_API_KEY. Ist sie noch in deiner Umgebung gesetzt, kann sie den Schlüssel des Anbieters überschreiben – und deine Anfragen gehen stillschweigend zum vollen Preis an Anthropic. - Die Qualität wird anders sein. Claude Code ist auf Claude-Modelle abgestimmt. Bei einfachen Aufgaben ist der Unterschied kaum spürbar, bei langen agentischen Sitzungen schon.
Wie der Agent selbst, Skills, Subagents und Hooks funktionieren, haben wir ausführlich in Wie ein KI-Agent funktioniert erklärt.
Wo der Haken ist
Begeisterte Testberichte hören an dieser Stelle meist auf. Wir nicht. Hier sind vier Dinge, die du verstehen solltest, bevor du deine Arbeit auf ein chinesisches Modell umstellst.
1. „Selbst betreiben“ heißt nicht „auf dem Laptop“
Testberichte schreiben gern, dass chinesische Modelle über Ollama oder LM Studio direkt auf deinem Rechner laufen. Technisch ja. Praktisch nur die kleinen Versionen. Das Flaggschiff GLM-5.1 hat rund 744 Milliarden Parameter, Kimi K3 sogar 2,8 Billionen. Dafür brauchst du keinen Laptop, sondern ein Serverrack mit mehreren teuren Grafikkarten.
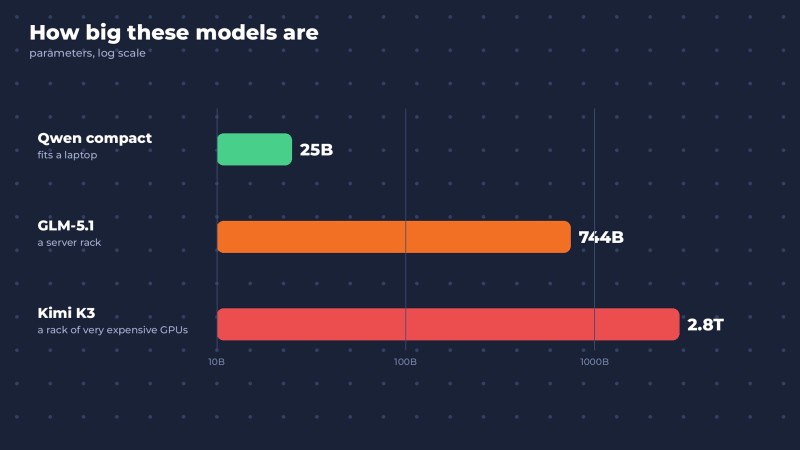
Auf einem normalen Rechner laufen realistisch kompakte destillierte Modelle – zum Beispiel kleinere Qwen-Versionen mit 20–30 Milliarden Parametern. Sie sind nützlich, erreichen aber nicht das Niveau der Flaggschiffe.
2. Wohin deine Daten gehen
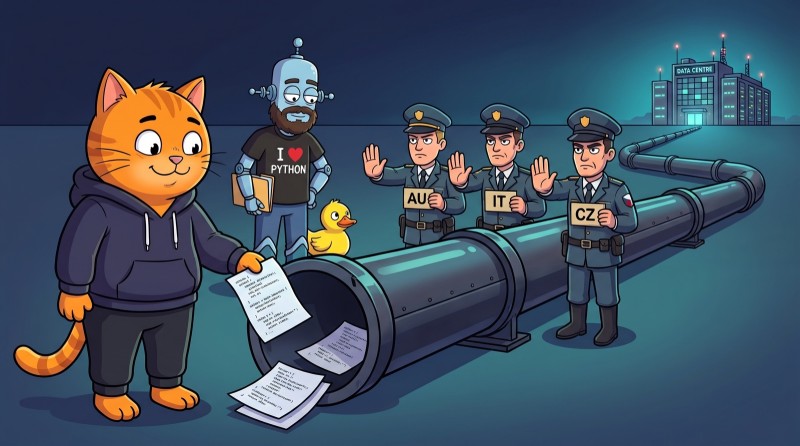
Ein offenes Modell auf deinem eigenen Server ist das eine. Die Cloud-API eines chinesischen Unternehmens ist etwas ganz anderes. Die Datenschutzerklärung von DeepSeek sagt klar, dass Anfragen und hochgeladene Dateien auf Servern in China gespeichert werden. Genau deshalb hat Australien DeepSeek auf Regierungsgeräten verboten, die italienische Datenschutzbehörde wollte die App aus den Stores entfernen lassen, und Tschechien und Taiwan haben sie in Behörden untersagt.
Eine praktische Regel: Ein privates Nebenprojekt über eine chinesische API – gerne. Code deiner Firma, Schlüssel, Kundendaten – nur über einen lokalen Betrieb oder einen westlichen Anbieter, der die offenen Gewichte selbst hostet. Dieselben Gewichte, aber die Daten bleiben unter deiner Kontrolle.
3. KI-Müll gibt es trotzdem
Ein günstiges Modell macht nicht seltener Fehler als ein teures, manchmal sogar öfter. Bei komplexer Logik und langen agentischen Aufgaben liefern chinesische Modelle spürbar öfter selbstbewusst nicht funktionierenden Code oder erfinden Methoden, die es nicht gibt. Benchmarks, die die Unternehmen selbst veröffentlichen, solltest du mit Vorsicht genießen: Sie messen, was sich bequem messen lässt.
4. „Offen“ heißt nicht „mach, was du willst“
MIT und Apache 2.0 sind wirklich freie Lizenzen. Kimi K3 hat dagegen eine eigene Lizenz mit Bedingungen für große kommerzielle Anbieter. Bevor du ein Produkt auf einem Modell aufbaust, nimm dir zehn Minuten und lies die Lizenz. Das ist billiger, als später die Architektur umzubauen.
Was das für Entwickler bedeutet
Es gibt einen alten Gedanken, auf den wir immer wieder zurückkommen: Werkzeuge werden auf null gesetzt, Grundlagen bleiben. Chinesische Modelle zeigen das so deutlich wie nichts anderes.
Vor einem Jahr war der Zugang zu einem starken Modell ein Vorteil. Heute bekommst du ein Modell auf Flaggschiff-Niveau kostenlos, und in einem Monat erscheint das nächste – ebenfalls kostenlos. Modelle werden zum Rohstoff, wie Strom. Niemand ist stolz darauf, dass aus seiner Steckdose Strom kommt.
Der Wert verlagert sich zu dem, der mit diesem Strom umgehen kann. Ein Modell passend zu Aufgabe und Budget auswählen. Es mit einem Agenten verbinden. Prüfen, was es geschrieben hat – und merken, wo es sich selbstbewusst geirrt hat. Rechte so einrichten, dass der Agent nichts anrichtet. Genau diese Fähigkeit wird bezahlt. Und sie verliert mit dem nächsten Modell nicht an Wert – im Gegenteil.

Das beste Modell ist nicht das, das im Benchmark vorne liegt, sondern das, dessen Ergebnis du prüfen kannst.
Wo du das lernst
Mit Agenten so zu arbeiten, dass du von keinem einzelnen Modell abhängig bist – genau darum geht es in unserem Kurs Entwickeln mit Claude Code von der AI Academy. 16 Level und 200+ Aufgaben: Rechte und Kontext, Skills, Subagents, MCP, Hooks, Plan Mode und Kontrolle über Git. Das alles funktioniert gleich, egal welches Modell unter der Haube steckt.
Und wenn du gerade erst mit dem Programmieren anfängst, starte mit den Grundlagen: Um zu prüfen, was ein Modell schreibt, musst du Code selbst lesen können. Genau das trainiert unser Python-Kurs mit Tausenden Aufgaben und sofortiger Prüfung.
Häufige Fragen
Welche chinesischen KI-Modelle sind 2026 die besten? Stand Ende Oktober 2026 sind die wichtigsten DeepSeek V4 (die günstigste API), Qwen 3.8 von Alibaba (das beliebteste offene Modell), Kimi K3 von Moonshot AI (agentisches Coding und große Repositorys), die GLM-5-Reihe von Z.ai (Coding, Arbeit in Claude Code) und MiniMax M3 (eine Million Tokens Kontext und Multimodalität). Für Bilder und Videos: Seedream 5.0 und Seedance 2.0 von ByteDance.
Können chinesische KI-Modelle ChatGPT und Claude ersetzen? Für viele Aufgaben ja: Automatisierung, Dokumentenverarbeitung, Codegenerierung mittlerer Komplexität. Bei komplexer Logik und langen agentischen Szenarien machen chinesische Modelle noch öfter Fehler. Die größten Vorteile sind API-Preise, die ein Vielfaches niedriger sind, und die Möglichkeit, das Modell auf dem eigenen Server zu betreiben.
Was kostet die API chinesischer KI-Modelle? DeepSeek V4.1 Flash kostet ab 0,15 $ pro Million Eingabe- und 0,60 $ pro Million Ausgabe-Tokens. Kimi K3 kostet 3 $ und 15 $. Zum Vergleich: Claude Sonnet 5.5 kostet 2 $ und 10 $, GPT-5.5 kostet 5 $ und 30 $. Die Preise ändern sich oft, prüfe daher die offiziellen Preisseiten der Anbieter.
Kann ich ein chinesisches KI-Modell auf meinem eigenen Rechner betreiben? Nur kompakte Versionen – zum Beispiel kleinere Qwen-Modelle mit 20–30 Milliarden Parametern über Ollama oder LM Studio. Flaggschiffe wie GLM-5.1 (rund 744 Milliarden Parameter) oder Kimi K3 (2,8 Billionen) brauchen Server-Hardware mit mehreren leistungsstarken Grafikkarten.
Ist es sicher, Code an chinesische KI-Modelle zu schicken? Über eine Cloud-API mit Vorsicht: DeepSeek speichert zum Beispiel Anfragen und Dateien auf Servern in China, weshalb mehrere Länder es auf Regierungsgeräten verboten haben. Für Firmencode und Kundendaten ist es sicherer, offene Gewichte lokal oder über einen westlichen Anbieter zu betreiben, der sie selbst hostet.
Wie nutze ich DeepSeek oder Kimi mit Claude Code? Über Umgebungsvariablen: ANTHROPIC_BASE_URL auf die Anthropic-kompatible Adresse des Anbieters setzen (zum Beispiel https://api.deepseek.com/anthropic), den Schlüssel des Anbieters in ANTHROPIC_AUTH_TOKEN und den Modellnamen in ANTHROPIC_MODEL. Das ist eine von den Anbietern dokumentierte, aber von Anthropic nicht offiziell unterstützte Konfiguration.
GO TO FULL VERSION