A conexão está quase pronta. O agente montou o config, nomeou o serviço e parou num único campo: API key. O serviço entregou uma string longa, e ela sozinha não diz onde colocá-la. Numa mensagem? Num arquivo ao lado do código? Direto no config, só para garantir que funcione?
Vamos entender isso com um único modelo. O(a) senhor(a) vai ver onde o valor é definido, qual processo o recebe e como confirmar que tudo está configurado sem revelar o próprio segredo. O modelo é o mesmo para uma execução local, para uma conexão MCP e para uma aplicação publicada - o que muda é apenas de quem é o ambiente que está sendo configurado.
O que uma chave de acesso oferece
Uma chave liga uma requisição a uma conta ou a um projeto, e às permissões concedidas ao(à) senhor(a). Por meio dela o serviço entende quem fez a chamada, o que essa pessoa pode fazer e quanto já usou. O significado exato de uma chave depende do serviço específico. Às vezes é acesso a toda a conta, às vezes só a um projeto e só para leitura.
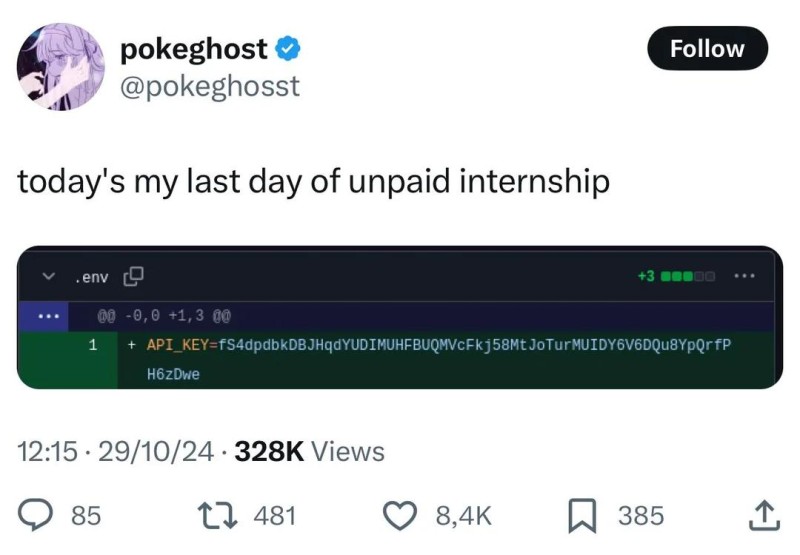
Junto com a palavra "chave", as instruções também costumam trazer token. Em textos do dia a dia os dois costumam ser usados como se fossem a mesma coisa, mas os detalhes do mecanismo são diferentes: a forma de obtenção, a validade e o conjunto de permissões. Melhor não tratá-los como sinônimos exatos - o que o serviço realmente emite está descrito na documentação dele.
Por que o serviço precisa distinguir os usuários fica mais fácil de ver com um exemplo do dia a dia. O(a) senhor(a) criou uma conta, escolheu um plano com limite mensal de requisições e recebeu uma chave. A partir daí o serviço usa essa chave para contar as requisições, compará-las com o limite e, num plano pago, gerar a cobrança. Uma chave que cai em mãos erradas significa que outra pessoa passa a gastar o seu limite e a aumentar a sua fatura.
A chave em si não decide nada. Ela dá ao serviço uma referência às configurações do dono, e é o próprio serviço quem decide se essa requisição em particular é permitida e se ela deve ser descontada do limite.
Também existem valores que o serviço marca de propósito como públicos, e justamente esses devem ir no código da página. Não dá para distinguir um valor público de um secreto pelo nome da variável. A finalidade está descrita na documentação, é lá que se deve olhar. Nos exemplos abaixo aparecem sempre placeholders óbvios, como fc-EXAMPLE-0000000000 - uma chave de verdade não se parece com isso.
Onde a aplicação pode guardar o segredo
Imagine a seguinte situação. O(a) senhor(a) colocou a chave direto no código da página, rodou o projeto e recebeu uma resposta da API. Tudo funciona. Depois de publicar, a aplicação também abre, as requisições passam - parece que o trabalho está feito.
Mas junto com o código, o navegador de cada visitante recebe a chave também. Basta abrir as ferramentas de desenvolvedor, encontrá-la no JavaScript ou numa requisição e copiar. A partir daí essa pessoa pode enviar as próprias requisições em nome do(a) senhor(a). Elas vão consumir o seu limite até o serviço começar a rejeitar as requisições do(a) próprio(a) senhor(a).

O problema não está numa ferramenta de build específica. Tudo o que a página enviou ao navegador fica disponível para o dono dele: HTML, estilos, JavaScript, endereços e cabeçalhos de requisição. Mesmo que a chave tenha sido pega de um .env local durante o build, depois de ser inserida no JavaScript ela viajou até o visitante junto com o resto do código.
Backend é o código que roda no servidor. O visitante recebe as respostas dele, mas não o código-fonte nem as variáveis de ambiente do processo do servidor. Por isso o backend pode guardar a chave consigo e chamar o serviço externo em nome da aplicação.
O esquema da requisição muda. O navegador envia uma requisição comum ao backend, sem a chave secreta. O backend lê a chave do próprio ambiente, a acrescenta numa requisição separada à API e devolve ao navegador apenas o resultado.
Agora o visitante vê o endereço do backend e os dados da resposta, mas não a chave do serviço externo. O segredo fica com o processo que o usa.
Um segredo tem dois donos possíveis:
- um processo local - o Claude Code com uma integração conectada, um script ou um servidor de desenvolvimento. Ele roda no seu computador e recebe a chave ali mesmo;
- o backend de uma aplicação publicada - código no servidor que chama a API externa por conta própria. O ambiente dele é configurado no painel da hospedagem.
São duas configurações separadas. Uma chave do ambiente do seu computador não aparece sozinha na hospedagem, mesmo que o serviço e o nome da variável sejam os mesmos.
Mover a chave para o backend a esconde do navegador, mas um backend público ainda precisa de proteção contra requisições de terceiros.
Antes de o Claude Code pedir para definir um valor, peça a ele que nomeie duas coisas: qual processo vai usar a chave e de que forma o valor vai chegar até esse processo. Se não houver resposta, ainda não há o que configurar.
Como funciona uma variável de ambiente
Uma variável de ambiente é um valor nomeado que um programa recebe ao iniciar. Ela tem um nome, por exemplo FIRECRAWL_API_KEY, e um valor, aquela string longa. Nos configs e no código se escreve o nome; o valor vive à parte e não fica guardado junto do código.
De onde o programa pega isso. Um programa iniciado num terminal herda o ambiente desse terminal. Definiu a variável numa janela, iniciou o Claude Code a partir dela - o Claude Code a enxerga. Abriu uma segunda janela e definiu a variável ali - isso não afeta um processo que já está rodando, pois ele recebeu o ambiente no início.
Daí vem o motivo mais comum da queixa "mas a chave está definida e não funciona". O valor foi definido na janela errada ou depois de o processo já ter iniciado. Resolve-se reiniciando o processo a partir do terminal onde a variável existe.
Uma versão didática, com um valor claramente fictício:
# bash: variável para o terminal atual
export FIRECRAWL_API_KEY=fc-EXAMPLE-0000000000
# PowerShell: a mesma coisa
$env:FIRECRAWL_API_KEY = "fc-EXAMPLE-0000000000"Com um placeholder num exemplo didático, tudo bem escrever assim. Não vale a pena digitar uma chave de verdade desse jeito: a linha inteira vai para o histórico de comandos e fica lá mesmo depois de o terminal ser fechado. Para um valor de verdade existe a entrada sem eco - o(a) senhor(a) cola a string, nada aparece na tela, e só o próprio comando entra no histórico:
# bash: o valor é digitado de forma oculta
read -s -r FIRECRAWL_API_KEY
export FIRECRAWL_API_KEY
# PowerShell: entrada oculta e extração do valor para a variável de ambiente
$secure = Read-Host "FIRECRAWL_API_KEY" -AsSecureString
$env:FIRECRAWL_API_KEY = [System.Net.NetworkCredential]::new('', $secure).PasswordA configuração deve ser conferida de um jeito que o valor não apareça na tela, no log ou num print. Para responder "está configurado ou não", duas linhas bastam:
# bash
[ -n "$FIRECRAWL_API_KEY" ] && echo "definida" || echo "não definida"
# PowerShell
if ($env:FIRECRAWL_API_KEY) { "definida" } else { "não definida" }Não é preciso imprimir nem o tamanho nem os primeiros caracteres. Isso não ajuda em nada na verificação, e um fragmento da chave já é parte do segredo.
Há muitas formas de definir uma variável permanentemente, e cada sistema tem as suas. Não é preciso se aprofundar nisso agora: para o trabalho local o terminal basta, e na hospedagem as variáveis são definidas no próprio painel dela.
Uma variável de ambiente é uma forma de não escrever o segredo no código, não uma medida de segurança. O valor não é criptografado, e qualquer programa rodando no mesmo ambiente o lê livremente. É exatamente por isso que importa de quem é o processo que o(a) senhor(a) está configurando.
Para que servem .env e .env.example
Definir variáveis à mão em cada terminal novo cansa rápido, então os valores são reunidos num arquivo de texto chamado .env. Cada linha nele guarda um par de nome e valor.
O detalhe que mais se ignora: o arquivo, sozinho, não configura nada. Alguém precisa lê-lo e distribuir os valores pelo ambiente do processo - a aplicação, uma biblioteca ou o launcher que inicia o seu programa. Não dá para simplesmente criar o .env e supor que qualquer programa vai reconhecê-lo. Vale a pena descobrir de fato o que carrega o arquivo no seu caso, em vez de presumir.
Ao lado dele costumam ficar mais dois arquivos:
# .env - fica só na sua máquina
FIRECRAWL_API_KEY=fc-EXAMPLE-0000000000
# .env.example - modelo para quem abrir o projeto
# valores vazios, aqui só ficam os nomes
FIRECRAWL_API_KEY=# .gitignore
.env| Arquivo | Para que serve | O que tem dentro |
|---|---|---|
.env | valores locais para execução | nomes e valores reais, só no seu computador |
.env.example | dica para quem abre o projeto | os mesmos nomes com valores vazios, às vezes um comentário curto |
.gitignore | regra para o arquivo local não ir para o repositório | uma linha com o nome do arquivo |
O sentido dessa separação é simples. O .env.example responde à pergunta "de quais variáveis esse projeto precisa" e pode ficar tranquilamente no repositório, porque não tem valores dentro. Chaves de verdade nunca são colocadas nele, nem temporariamente.
Se o(a) senhor(a) ainda não conhece o Git, basta lembrar aqui o papel do .gitignore. Ele lista os arquivos que não devem ser adicionados ao repositório. Vamos ver Git e .gitignore em detalhe no nível 13.
E agora a armadilha do .gitignore em que as pessoas caem o tempo todo. A regra só vale para arquivos que o Git ainda não rastreia. Se o .env já foi commitado uma vez, adicionar uma linha ao .gitignore não vai tirá-lo do rastreamento. O arquivo continua sob controle de versão, e as mudanças nele vão continuar entrando nos commits. A própria documentação do Git diz isso claramente: regras de ignorar não afetam arquivos que o Git já rastreia. Documentação do gitignore.
No esquema, a condição principal fica no meio. A mesma linha em .gitignore só ajuda enquanto o .env não é rastreado. Um arquivo já rastreado precisa de um passo à parte.
Por isso, antes de escrever um segredo de verdade no arquivo, vale garantir que o Git não sabe dele. O git status mostra se o arquivo aparece entre as mudanças. Se ele já é rastreado, tira-se do rastreamento com git rm --cached .env e commita-se essa mudança - o arquivo continua no disco, mas sai do controle de versão.
Só que isso afeta apenas os commits futuros. Um valor que já entrou no histórico continua lá, e é preciso lidar com isso de outra forma - mais sobre isso adiante.
Como passar uma chave para uma conexão MCP
MCP é uma forma de conectar uma ferramenta externa ao Claude Code. A conexão é descrita num arquivo .mcp.json, e esse arquivo geralmente fica no repositório junto do projeto, ou seja, toda a equipe o vê. Portanto, não deve haver segredo nenhum ali dentro.
Uma conexão mínima com o serviço Firecrawl via HTTP se parece com isto:
{
  "mcpServers": {
    "firecrawl": {
      "type": "http",
      "url": "https://mcp.firecrawl.dev/v2/mcp",
      "headers": {
        "Authorization": "Bearer ${FIRECRAWL_API_KEY}"
      }
    }
  }
}
Não há chave nenhuma no arquivo. No cabeçalho está ${FIRECRAWL_API_KEY} - uma referência à variável de ambiente pelo nome. O Claude Code substitui isso pelo valor do ambiente do processo em que está rodando. O nome vai para o repositório, e cada pessoa tem o próprio valor. O Claude Code consegue fazer esse tipo de substituição nos campos url, headers, env, command e args. Claude Code sobre MCP.
No esquema dá para ver que duas coisas de lugares diferentes se encontram no cabeçalho da requisição. O modelo do cabeçalho vem do config compartilhado, e o valor é inserido a partir do ambiente do processo. Em nenhuma etapa a chave é escrita num arquivo que vai para o repositório.
O endereço e a forma de passar a chave vêm da documentação do próprio serviço. No Firecrawl é o cabeçalho Authorization, e a documentação pede especificamente para não colocar a chave no endereço MCP. O motivo é simples: um endereço é texto comum, ele vai para o config, para os logs e para o histórico de comandos, e a chave iria junto.
Alguns serviços aceitam login pelo navegador. O cliente abre sozinho a página de login, e não é preciso passar a API key à mão de jeito nenhum. O Firecrawl tem um endereço próprio para isso. Documentação do Firecrawl sobre MCP.
Se a ferramenta não responder, o(a) senhor(a) deve conferir nesta ordem:
- o nome da variável no config e o nome que o(a) senhor(a) definiu coincidem até o último caractere;
- o valor está definido no processo a partir do qual o Claude Code foi iniciado;
- o processo foi reiniciado depois que a variável foi definida.
Quando a variável não existe, o Claude Code não falha em silêncio. Ele carrega o config, deixa o texto ${FIRECRAWL_API_KEY} sem substituir e imprime um aviso com o nome da variável ausente. O valor em si nunca é impresso, então esse diagnóstico é seguro. E não, não é preciso despejar o ambiente inteiro para achar o problema.

Este exemplo serve para entender uma conexão que já está pronta. Como se escolhe e adiciona um servidor, e quais permissões ele recebe, é um assunto à parte; aqui importa só onde o segredo vive nessa construção.
Se a chave já vazou
É uma situação comum. A chave foi parar numa mensagem, num commit ou num print. Não é motivo de pânico, mas também não vale a pena adiar. A ordem das ações é esta:
- revogar ou trocar a chave no painel do serviço. Este é o único passo depois do qual a string antiga para de abrir qualquer coisa;
- definir o novo valor onde ele for necessário: localmente, na hospedagem, nas configurações da conexão;
- tratar do lugar onde ela foi exposta - apagar a mensagem, corrigir o arquivo, fechar o acesso;
- ver no painel como a chave foi usada e o que o serviço mostra em termos de gastos.
A ordem é essa mesmo, e o primeiro passo não muda de lugar. Uma mensagem apagada ou um novo commit por cima do antigo não tornam o segredo anterior seguro. A mensagem pode ter sido lida, o repositório clonado, o histórico salvo. Enquanto a chave for válida, ela funciona para todo mundo que a tiver.
Sobre o repositório, à parte. Se o segredo entrou num commit, o GitHub tem um guia para remover esse tipo de dado. Removendo dados sensíveis de um repositório. Só tenha em mente que uma limpeza completa do histórico reescreve os commits já existentes, afetando todo mundo que trabalha com aquele repositório. Uma operação dessas se combina com os donos, não se faz por conta própria por causa de um artigo didático. Já a troca da chave é feita na hora, sem precisar combinar com ninguém.
O que delegar ao Claude Code
O agente cobre quase toda a mecânica deste artigo, com uma exceção: o próprio segredo quem digita é o(a) senhor(a). Faz sentido delegar a ele o seguinte:
- preparar o config com o nome da variável, não com o valor;
- dizer o que exatamente carrega a variável no processo e em qual processo ela precisa estar;
- verificar que o segredo não está no build do cliente nem nos arquivos rastreados pelo Git;
- rodar a verificação de acesso e relatar o resultado, sem imprimir o valor.
Fica com o(a) senhor(a) a digitação da chave de verdade, pelo mecanismo previsto para isso: entrada oculta no terminal, um arquivo local, o painel da hospedagem. O segredo nunca vai para uma mensagem, um print ou o relatório do agente, nem mesmo "por um segundo, só para conferir".
O pedido pode soar mais ou menos assim:
Conecte o serviço pela API. A chave fica por minha conta.
Pegue na documentação o endereço, o método e a forma de passar a chave.
No config, coloque o nome da variável de ambiente, não o valor.
Diga qual processo deve receber a variável e o que a carrega.
Verifique que a chave não está no build do cliente nem nos arquivos rastreados pelo Git.
Faça a verificação de acesso sem imprimir o valor ou partes dele.
Relate o resultado: configurado, não definido ou acesso negado.
Por último, sobre como ler o relatório. "A variável está definida" e "o acesso funciona" são afirmações diferentes, e uma não deve substituir a outra. A ausência de valor também é diferente de uma recusa do serviço. No primeiro caso não há com o que assinar a requisição; no segundo o serviço respondeu, mas negou o acesso. Se o agente só disser "pronto", pergunte exatamente o que ele conferiu.
O segredo não é enviado a um chat, nem mostrado num print, nem colocado num arquivo que vai para o repositório. Tudo o mais neste artigo são formas de seguir essa regra sem atrapalhar o trabalho.
GO TO FULL VERSION