1. はじめに
一次元配列は、ピザの箱のように長くて、すべてのスライスが一直線に並んでいるものだと想像してください — おいしいけれど単調です。
では、作業スケジュールやチェス盤を思い浮かべてみましょう。そこではすべてが 行 と 列 に整理されています — つまり 表 です。これこそが二次元配列の典型的な出番です。
現実の世界では、二次元配列は至るところにあります:
- 従業員の給与表(行=従業員、列=月)。
- 画面上の画像(各「セル」はピクセルの色で、X と Y の 2 つの座標を持つ)。
- 行列計算やデータ処理。
- チェス盤や三目並べの盤面。
二次元配列は、しばしば 行列 とも呼ばれます(数学から来た名称です)。
二次元配列が必要になる場面は数え切れません。ほとんどのボードゲームの実装は、そのまま二次元配列です: 「チェス」、「チェッカー」、「三目並べ」、「海戦(Battleship)」:

「チェス」や「海戦(Battleship)」の盤面は、二次元配列にぴったり当てはまります。マス目の座標として使うのは数字だけで十分です。 「ポーン e2 ⟶ e4」ではなく、「ポーン (4,1) ⟶ (4,3)」のように。プログラマにとってはその方がむしろ簡単です。
2. 二次元配列の宣言構文
最初の宣言までは怖いだけ! 一歩ずつ理解していきましょう。
基本ルール
tip[][] imyaMassiva;ここで空の [] が 2 つあるのは、徹夜のコーヒーでコンパイラが壊れたからではなく、「配列が 二次元 だ」という指定です。

例
int[][] matrix;
double[][] gradesTable;
string[][] chessBoard;
配列の作成
サイズ(行 と 列 の数)を指定します。
matrix = new int[3][4]; // 3 行、4 列
これは 3x4 の表です。3 行 4 列の Excel の表を思い浮かべてください。
変数の宣言と二次元配列の作成を同時に行うこともできます:
int[][] matrix = new int[3][4];
一次元配列と同様に、値で直接初期化することもできます:
int[][] example = {
    {1, 2, 3},
    {4, 5, 6},
    {7, 8, 9}
};
// 3 行 3 列の表
視覚的な図
┌─────┬─────┬─────┬─────┐
│  0  │  1  │  2  │  3  │  ← 列 (Columns)
├─────┼─────┼─────┼─────┤
│ 0,0 │ 0,1 │ 0,2 │ 0,3 │  ← 行 0 (Row 0)
├─────┼─────┼─────┼─────┤
│ 1,0 │ 1,1 │ 1,2 │ 1,3 │  ← 行 1 (Row 1)
├─────┼─────┼─────┼─────┤
│ 2,0 │ 2,1 │ 2,2 │ 2,3 │  ← 行 2 (Row 2)
└─────┴─────┴─────┴─────┘
各要素はインデックスの組 [行, 列] で指定します。
3. インデックスと要素へのアクセス
二次元配列では、要素にアクセスするために 2 つのインデックス を指定します:
- 最初は行番号。
- 二番目は列番号。
      // 2 行目(インデックス 1)の 3 列目(インデックス 2)
      matrix[1][2] = 99;
チェスに慣れている人への注意: インデックスは 0 から始まります。つまり最初の要素は [0][0] です.
書き込みと読み取り
int[][] data = new int[5][2];
data[1][1] = 5;         // 書き込み
int value = data[1][1]; // 読み取り
メモリ上ではこのように見えます:

4. 二次元配列の埋め方
これがどのように動くかを理解するために、1 から 12 までの連番で行列を埋めるコードを書いてみましょう。
int[][] matrix = new int[3][4];
int value = 1;

for (int row = 0; row < 3; row++)
{
    for (int col = 0; col < 4; col++)
    {
        matrix[row][col] = value;
        value++;
    }
}
図:
実行後:
┌────┬────┬────┬────┐
│ 1  │ 2  │ 3  │ 4  │
├────┼────┼────┼────┤
│ 5  │ 6  │ 7  │ 8  │
├────┼────┼────┼────┤
│ 9  │ 10 │ 11 │ 12 │
└────┴────┴────┴────┘
5. 二次元配列の仕組み
さて、二次元配列の本当の姿を見ていきましょう。準備はいいですか?
二次元配列は、実は「配列の配列」です!
言い換えると、一次元配列では「配列変数は配列要素を保持するコンテナへの参照を持つ」のに対して、二次元配列ではもう少しややこしい構造になります。二次元配列変数は『コンテナのコンテナ』への参照を持ち、その中の各セルには一次元配列への参照が入っています。百聞は一見にしかず — 図を見るのが早いでしょう:
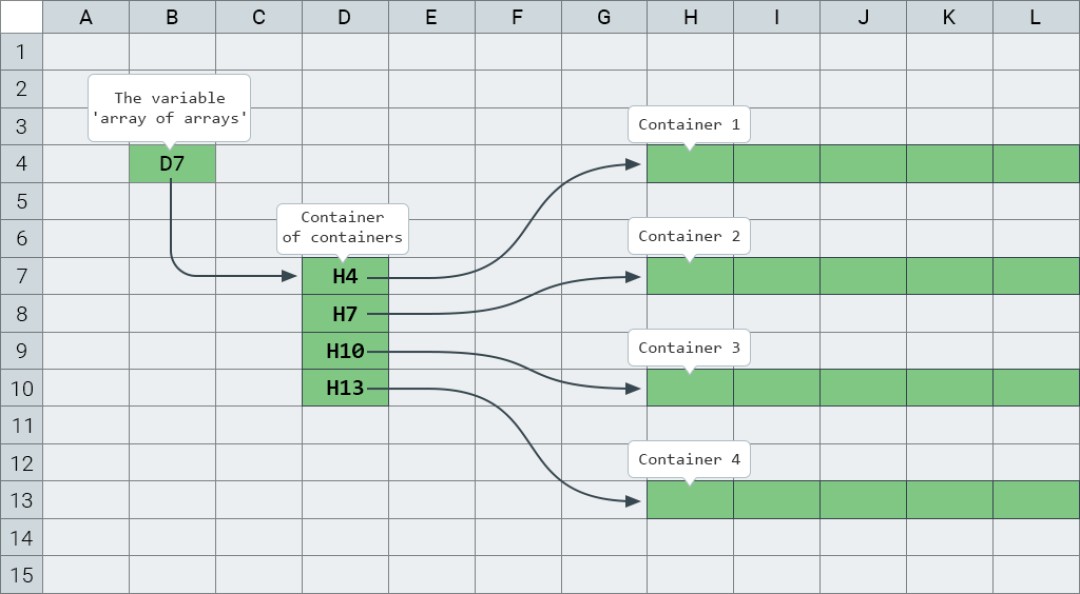
左側には「二次元配列変数」があり、「二次元配列オブジェクト」への参照を保持しています。中央には「二次元配列オブジェクト」があり、そのセルには一次元配列(=二次元配列の行)への参照が入っています。そして 右側には 4 つの一次元配列、すなわち私たちの二次元配列の各行が見えます。
これが二次元配列の実際の構造です。このアプローチは Java プログラマにいくつかの利点を与えます:
まず第一に、「コンテナのコンテナ」が行配列への参照を保持しているため、行の入れ替えが非常に簡単かつ高速にできます。「コンテナのコンテナ」にアクセスするには、2 つではなく 1 つのインデックスを指定すればよいのです。例:
int[][] data = new int[2][5];
int[] row1 = data[0];
int[] row2 = data[1];
次のようなコードで行を入れ替えられます:
// 重要なデータ行列
int[][] matrix = {
  {1, 2, 3, 4, 5},
  {5, 4, 3, 2, 1}
};

int[] tmp = matrix[0];
matrix[0] = matrix[1];
matrix[1] = tmp;
二次元配列の名前の後にインデックスを 1 つだけ指定すると、『コンテナのコンテナ』にアクセスすることになり、そのセルには通常の一次元配列への参照が格納されています。
6. 二次元配列を画面に出力する
二次元の表を出力するには、通常 2 重ループを使います — コンソールに迷路を描くのと同じ感覚です。例:
for (int row = 0; row < matrix.length; row++)
{
    for (int col = 0; col < matrix[row].length; col++)
    {
        System.out.print(matrix[row][col] + "\t");
    }
    System.out.println(); // 改行
}
出力例:
1	2	3	4
5	6	7	8
9	10	11	12
ところで、ここで数行のコードで表をきれいに「描く」方法を学びました!

GO TO FULL VERSION